ES5的继承

首先我们创建一个简单的父类

1
2
3
4
5
6
function Person(name){
this.name = name
}
Person.prototype.say = function(){
return 'hi'
}

继承父类
首先有一点需要说明,constructor属于不可枚举的属性

1
2
3
4
5
constructor:
configurable: true
enumerable: false // 不可枚举
value: ƒ Student(name, age)
writable: true
  • 组合继承 最常用的继承
1
2
3
4
5
6
7
8
9
10
11
12
13
function Student(name, age){
//拓展一个实例属性
Person.call(this, name); //其实很简单直接,就是调用一遍父类的this.x = x
this.age = age
}
//将子类的原型对象指向Person的实例
Student.prototype = new Person();
//将子类的原型对象的构造函数正确指回
Student.prototype.constructor = Student;
//新增一个实例方法
Student.prototype.sayAge = function(){
return this.age
};
  • 寄生组合继承 完美的继承

JavaScript高程里的写法,需要借助两个辅助函数

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
function inheritPrototype(subType, superType) {
let prototype = object(superType.prototype); // 创建对象
prototype.constructor = subType; // 增强对象
subType.prototype = prototype; // 赋值对象
}
function object(o) {
function F() {}
F.prototype = o;
return new F();
}
function SuperType(name) {
this.name = name;
this.colors = ["red", "blue", "green"];
}
SuperType.prototype.sayName = function () {
console.log(this.name);
};
function SubType(name, age) {
SuperType.call(this, name);
this.age = age;
}
inheritPrototype(SubType, SuperType);
SubType.prototype.sayAge = function () {
console.log(this.age);
};

下边是网上的变种(倒是能用)

第一种方式,感觉不太好

1
2
3
4
5
6
7
8
9
10
11
12
13
14
function Student(name, age){
Person.call(this, name);
this.age = age
}
// Object.assign 无法复制继承属性及不可枚举的数据 以及get set函数
Student.prototype = Object.assign(Object.create(Person.prototype), Student.prototype)
// 所以需要重新赋值constructor,但是用这种方法constructor属性就变为可枚举属性了
Student.prototype.constructor = Student;
Student.prototype.sayAge = function(){
return this.age
};

const student = new Student('lucy',30)
console.log(student);

第二种方式,可以解决枚举属性的问题

1
2
3
4
5
6
7
8
Student.prototype = Object.create(Person.prototype, {
constructor: {
value: Student,
enumerable: false,
writable: true,
configurable: true
}
})

第三种方式是我自己想的,结合Object.getOwnPropertyDescriptors()
该函数的参数是Student.prototype,第一次写的时候忘了写.prototype

1
2
3
4
Student.prototype = Object.create(
Person.prototype,
Object.getOwnPropertyDescriptors(Student.prototype)
)

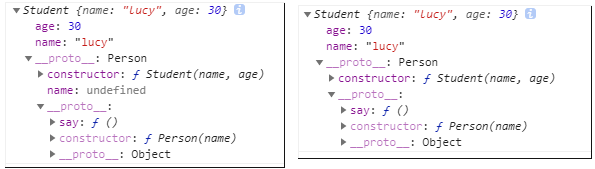
下图是控制台输出,左边是组合继承,右边是寄生组合继承
控制台输出


我们为什么要把子类的prototype指向父类的实例而不是父类的prototype呢
如果我们把子类的原型对象直接指向父类的原型对象,扩展子类会影响到父类

将子类的原型对象直接指向父类的原型对象,给子类添加额外的原型方法

1
2
3
4
5
6
7
8
9
10
11
12
function Student(name, age){
Person.call(this, name);
this.age = age
}
Student.prototype = Person.prototype;
Student.prototype.constructor = Student;

Student.prototype.sayAge = function(){
return this.age
};
console.log(Person.prototype);
console.log(Student.prototype);

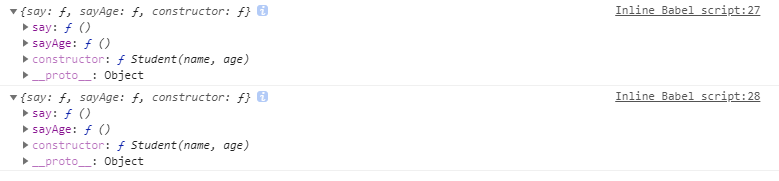
控制台结果
我们可以看到父类的prototype已经被子类改变了,这明显不符合我们的目的

ES5继承的帮助记忆

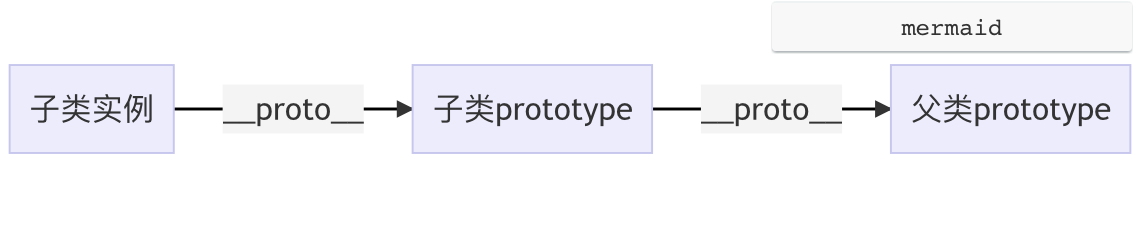
子类的prototype必须是某个对象(这个对象的__proto__必须指向父类的prototype)

满足这个条件的某个对象:

  • 父类的实例 组合继承
  • Object.create(父类.prototype) 寄生组合继承

满足条件后子类的实例可以通过两个__proto__查找,访问到父类原型对象,即

控制台输出

ES6的继承

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
class Person {
constructor(name){
this.name = name //实例属性
}
say(){ //原型方法
return 'hi'
}
}
class Student extends Person{
constructor(name, age){
super(name)
this.age = age
}
}
const student = new Student('lucy',30)
console.log(student);

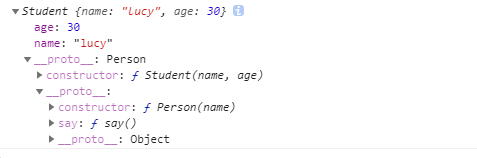
控制台输出与ES5寄生组合继承一致

控制台结果

数据类型

  • 基本数据类型
    • Undefined
    • Null
    • Boolean
    • Number
    • String
    • Symbol
  • 复杂类型:
    • Object

typeof操作符

对一个值使用 typeof 操作符会返回下列字符串之一:

  • “undefined”表示值未定义
  • “boolean”表示值为布尔值
  • “string”表示值为字符串
  • “number”表示值为数值
  • “object”表示值为对象(而不是函数)或 null
  • “function”表示值为函数
  • “symbol”表示值为符号
1
2
3
4
let message = "some string"; 
console.log(typeof message); // "string"
console.log(typeof(message)); // "string"
console.log(typeof 95); // "number"

typeof 是一个操作符而不是函数,所以不需要参数(但可以使用参数)

数据类型简介

Undefined

Undefined 类型只有一个值,就是特殊值 undefined。
包含 undefined 值的变量跟未定义变量是有区别的

1
2
3
4
let message;    // 这个变量被声明了,只是值为 undefined 
// 确保没有声明过这个变量 // let age
console.log(message); // "undefined"
console.log(age); // 报错

但是 typeof 操作符返回的结果是没有区别的,都是”undefined”

Null

Null 类型同样只有一个值,即特殊值 null。逻辑上讲,null 值表示一个空对象指针,这也是给 typeof 传一个 null 会返回”object”的原因
undefined 值是由 null 值派生而来的,因此 ECMA-262将它们定义为表面上相等,如下面的例子所示:

1
2
console.log(null == undefined);  // true 
console.log(null === undefined); // false

Boolean

Boolean(布尔值)类型有两个字面值:true 和 false。
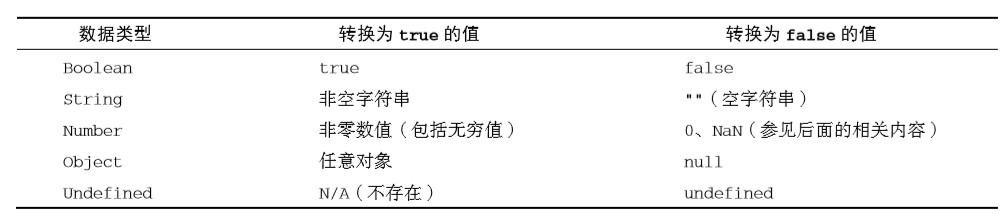
虽然布尔值只有两个,但所有其他 ECMAScript类型的值都有相应布尔值的等价形式。要将一个其他类型的值转换为布尔值,可以调用特定的 Boolean()转型函数:
转换规则如下:

Dingtalk_20210407163159

number

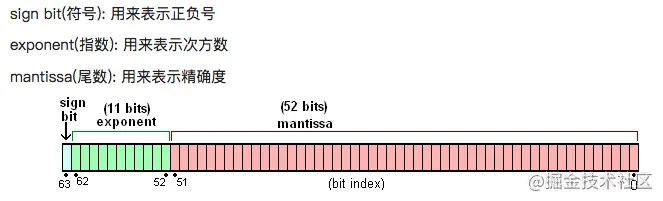
Number 类型使用的是双精度浮点型,也就是其他语言中的double类型。而双精度浮点数使用64 bit来进行存储

img

双精度浮点数详细介绍

三种基本类型

整数

最基本的数值字面量格式是十进制整数,直接写出来即可:

1
let intNum = 55; // 整数 

整数也可以用八进制(以 8 为基数)或十六进制(以 16 为基数)字面量表示。

如下所示:

1
2
3
let octalNum1 = 070; // 八进制的 56  
let octalNum2 = 079; // 无效的八进制值,当成 79 处理
let octalNum3 = 08; // 无效的八进制值,当成 8 处理

八进制字面量在严格模式下是无效的,会导致 JavaScript 引擎抛出语法错误。

要创建十六进制字面量,必须让真正的数值前缀 0x(区分大小写),

1
2
let hexNum1 = 0xA; // 十六进制 10  
let hexNum2 = 0x1f; // 十六进制 31

使用八进制和十六进制格式创建的数值在所有数学操作中都被视为十进制数值。

浮点数

要定义浮点值,数值中必须包含小数点,而且小数点后面必须至少有一个数字。

因为存储浮点值使用的内存空间是存储整数值的两倍,所以 ECMAScript 总是想方设法把值转换为 整数。

如下例所示:

1
2
let floatNum1 = 1.; // 小数点后面没有数字,当成整数 1 处理
let floatNum2 = 10.0; // 小数点后面是零,当成整数 10 处理

浮点值的精确度最高可达 17 位小数,但在算术计算中远不如整数精确。例如,0.1 加 0.2 得到的不 是 0.3,而是 0.300 000 000 000 000 04。

NaN

有一个特殊的数值叫 NaN,意思是“不是数值”(Not a Number),用于表示本来要返回数值的操作 失败了(而不是抛出错误)。

NaN 有几个独特的属性:

  • 任何涉及 NaN 的操作始终返回 NaN(如 NaN/10)

  • NaN 不等于包括 NaN 在内的任何值

    • ECMAScript 提供了 isNaN()函数

    把一个值传给 isNaN()后,该函数会尝试把它转换为数值。(使用哪种转换规则未知)待补充

    1
    2
    3
    4
    5
    console.log(isNaN(NaN)); // true 
    console.log(isNaN(10)); // false,10 是数值
    console.log(isNaN("10")); // false,可以转换为数值 10
    console.log(isNaN("blue")); // true,不可以转换为数值
    console.log(isNaN(true)); // false,可以转换为数值 1

数值转换

Number()、parseInt()和 parseFloat()

Number()是 转型函数,可用于任何数据类型。后两个函数主要用于将字符串转换为数值

Number()

Number()是 转型函数,可用于任何数据类型。

Number()函数基于如下规则执行转换(一元加操作符与 Number()函数遵循相同的转换规则)。

  • 布尔值,true 转换为 1,false 转换为 0。
  • 数值,直接返回。
  • null,返回 0。
  • undefined,返回 NaN。
  • 字符串,应用以下规则。
    - 如果字符串包含数值字符,包括数值字符前面带加、减号的情况,则转换为一个十进制数值。 因此,Number(“1”)返回 1,Number(“123”)返回 123,Number(“011”)返回 11(忽略前面 的零)。
    - 如果字符串包含有效的浮点值格式如”1.1”,则会转换为相应的浮点值(同样,忽略前面的零)。
    - 如果字符串包含有效的十六进制格式如”0xf”,则会转换为与该十六进制值对应的十进制整 数值。
    - 如果是空字符串(不包含字符),则返回 0。
    - 如果字符串包含除上述情况之外的其他字符,则返回 NaN。

    • Number("a1"); NaN
      let num1 = Number("Hello world!"); // NaN 
      let num2 = Number(""); // 0 
      let num3 = Number("000011"); // 11 
      let num4 = Number(true); // 1 
      
      1
      2
      3
      4
      5
      6
      7
      8
      9
      10
      11
      12
      13
      14

      - 对象,调用 valueOf()方法,并按照上述规则转换返回的值。如果转换结果是 NaN,则调用 toString()方法,再按照转换字符串的规则转换。

      #### parseInit()

      parseInt()函数更专注于字符串是否包含数值模式,接收第二个参数,用于指定**底数(进制数)**。。

      parseInt()函数基于如下规则执行转换

      - 字符串最前面的空格会被 忽略,从第一个非空格字符开始转换
      - 如果第一个字符不是数值字符、加号或减号,parseInt()立即 返回 NaN
      - 如果第一个字符是数值字符、加号或减号,则继续依次检测每个字符,**直到字符串末尾,或碰到非数值字符**
      - 字符串以"0x"开头,就会被解释为十六进制整数。如果字符串以"0" 开头,且紧跟着数值字符,在**非严格模式**下会被**某些实现**解释为八进制整数

let num1 = parseInt(“1234blue”); // 1234
let num2 = parseInt(“”); // NaN
let num3 = parseInt(“0xA”); // 10,解释为十六进制整数
let num4 = parseInt(22.5); // 22
let num5 = parseInt(“70”); // 70,解释为十进制值
let num6 = parseInt(“0xf”); // 15,解释为十六进制整数
let num1 = parseInt(“AF”, 16); // 175
let num2 = parseInt(“AF”); // NaN

1
2
3
4
5
6
7
8
9
10
11

#### parseFloat()

parseFloat()函数的工作方式跟 parseInt()函数类似,但是**只能解析十进制值**

- 始终忽略字符串开头的零

- 解析到字符串末尾或者解析到一个无效的浮点数值字符为止

> 第一次出现的小数点是有 效的,但第二次出现的小数点就无效 "22.34.5"将转换 成 22.34

let num1 = parseFloat(“1234blue”); // 1234,按整数解析
let num2 = parseFloat(“0xA”); // 0
let num3 = parseFloat(“22.5”); // 22.5
let num4 = parseFloat(“22.34.5”); // 22.34
let num5 = parseFloat(“0908.5”); // 908.5
let num6 = parseFloat(“3.125e7”); // 31250000

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19

## Srting

String(字符串)数据类型表示零或多个 16 位 Unicode 字符序列。

> ECMAScript 中的字符串是不可变的,要修改 某个变量中的字符串值,必须先销毁原始的字符串,然后将包含新值的另一个字符串保存到该变量,**所有字符串方法都不会影响原字符串,无一例外**

### 转换为字符串

几乎所有值都有的 `toString()`方法。这个方法唯 一的用途就是返回当前值的字符串等价物。

> 用加号操作符给一个值加上一个空字符串""也可以将其转换为字符串

toString()方法可见于数值、布尔值、对象和字符串值。null 和 undefined 值没有 toString()方法(直接返回这两个值的字面量文本)

> 没错,字符串值也有 toString()方法, 该方法只是简单地返回自身的一个副本。

> 多数情况下,toString()不接收任何参数。不过,在对数值调用这个方法时,toString()可以接受以什么底数来输出数值的字符串表示
>

let num = 10;
console.log(num.toString()); // “10”
console.log(num.toString(2)); // “1010”
console.log(num.toString(8)); // “12”
console.log(num.toString(10)); // “10”
console.log(num.toString(16)); // “a”
``


详细见js高程第四版 5.3.3

POST提交数据时四种常见的数据格式

  • application/x-www-form-urlencoded
    浏览器的原生 表单,如果不设置 enctype 属性,那么最终就会以 application/x-www-form-urlencoded方式提交数据。

  • multipart/form-data
    我们使用表单上传文件时,必须让 表单的 enctype 等于 multipart/form-data

  • application/json
    JSON 格式支持比键值对复杂得多的结构化数据

  • text/xml
    XML-RPC(XML Remote Procedure Call),它是一种使用 HTTP 作为传输协议,XML 作为编码方式的远程调用规范。


get的编码类型 仅有 application/x-www-form-urlencoded

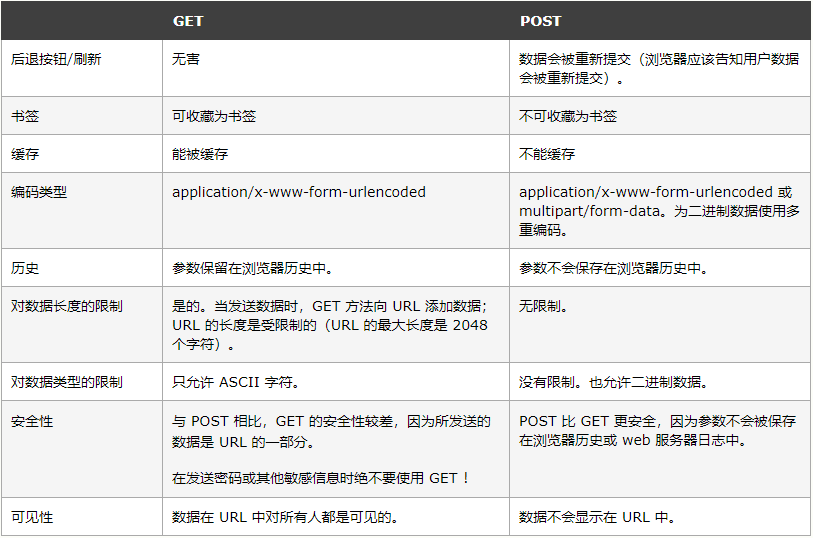
W3C列出的HTTP方法 POST和GET的区别

区别

常见解答 get post的区别

  • 1.GET请求的数据会附在URL之后,以?分割URL和传输数据,参数之间以&相连,POST把提交的数据则放置在是HTTP包的包体中。
  • 2.GET的长度受限于url的长度,而url的长度限制是特定的浏览器和服务器设置的,理论上GET的长度可以无限长。
  • 3.POST是没有大小限制的,HTTP协议规范也没有进行大小限制,起限制作用的是服务器的处理程序的处理能力
  • 4.在ASP中,服务端获取GET请求参数用Request.QueryString,获取POST请求参数用Request.Form。
  • 5.POST的安全性要比GET的安全性高application json 与form表单的区别?瀏覽器默認的提交方式就是表單。首先,Content-Type 被指定为 application/x-www-form-urlencoded,jQuery的Ajax请求默认方式,其次,数据以键值对形式?key1=value1&key2=value2的方式发送到服务器
  • 6.就是语义上的区别,get用于获取数据,post用于提交数据

post和get的选择?

私密性的信息请求使用post。查询信息和可以想要通过url分享的信息使用get。

promiseA+规范

转载自图灵社区

译者序:一年前曾译过 Promise/A+ 规范,适时完全不懂 Promise 的思想,纯粹将翻译的过程当作学习,旧文译下来诘屈聱牙,读起来十分不顺畅。谁知这样一篇拙译,一年之间竟然点击数千,成为谷歌搜索的头条。今日在理解之后重译此规范,以飨读者。

一个开放、健全且通用的 JavaScript Promise 标准。由开发者制定,供开发者参考。


译文术语

  • 解决(fulfill):指一个 promise 成功时进行的一系列操作,如状态的改变、回调的执行。虽然规范中用 fulfill 来表示解决,但在后世的 promise 实现多以 resolve 来指代之。
  • 拒绝(reject):指一个 promise 失败时进行的一系列操作。
  • 终值(eventual value):所谓终值,指的是 promise 被解决时传递给解决回调的值,由于 promise 有一次性的特征,因此当这个值被传递时,标志着 promise 等待态的结束,故称之终值,有时也直接简称为值(value)。
  • 据因(reason):也就是拒绝原因,指在 promise 被拒绝时传递给拒绝回调的值。

Promise 表示一个异步操作的最终结果,与之进行交互的方式主要是 then 方法,该方法注册了两个回调函数,用于接收 promise 的终值或本 promise 不能执行的原因。

本规范详细列出了 then 方法的执行过程,所有遵循 Promises/A+ 规范实现的 promise 均可以本标准作为参照基础来实施 then 方法。因而本规范是十分稳定的。尽管 Promise/A+ 组织有时可能会修订本规范,但主要是为了处理一些特殊的边界情况,且这些改动都是微小且向下兼容的。如果我们要进行大规模不兼容的更新,我们一定会在事先进行谨慎地考虑、详尽的探讨和严格的测试。

从历史上说,本规范实际上是把之前 Promise/A 规范 中的建议明确成为了行为标准:我们一方面扩展了原有规范约定俗成的行为,一方面删减了原规范的一些特例情况和有问题的部分。

最后,核心的 Promises/A+ 规范不设计如何创建、解决和拒绝 promise,而是专注于提供一个通用的 then 方法。上述对于 promises 的操作方法将来在其他规范中可能会提及。


Promise

promise 是一个拥有 then 方法的对象或函数,其行为符合本规范;

thenable

是一个定义了 then 方法的对象或函数,文中译作“拥有 then 方法”;

值(value)

指任何 JavaScript 的合法值(包括 undefined , thenable 和 promise);

异常(exception)

是使用 throw 语句抛出的一个值。

据因(reason)

表示一个 promise 的拒绝原因。

要求


Promise 的状态

一个 Promise 的当前状态必须为以下三种状态中的一种:等待态(Pending)、**执行态(Fulfilled)**和**拒绝态(Rejected)**。

等待态(Pending)

处于等待态时,promise 需满足以下条件:

  • 可以迁移至执行态或拒绝态

执行态(Fulfilled)

处于执行态时,promise 需满足以下条件:

  • 不能迁移至其他任何状态
  • 必须拥有一个不可变的终值

拒绝态(Rejected)

处于拒绝态时,promise 需满足以下条件:

  • 不能迁移至其他任何状态
  • 必须拥有一个不可变的据因

这里的不可变指的是恒等(即可用 === 判断相等),而不是意味着更深层次的不可变(译者注:盖指当 value 或 reason 不是基本值时,只要求其引用地址相等,但属性值可被更改)。

Then 方法

一个 promise 必须提供一个 then 方法以访问其当前值、终值和据因。

promise 的 then 方法接受两个参数:

1
promise.then(onFulfilled, onRejected)

参数可选

onFulfilled 和 onRejected 都是可选参数。

  • 如果 onFulfilled 不是函数,其必须被忽略
  • 如果 onRejected 不是函数,其必须被忽略

onFulfilled 特性

如果 onFulfilled 是函数:

  • 当 promise 执行结束后其必须被调用,其第一个参数为 promise 的终值
  • 在 promise 执行结束前其不可被调用
  • 其调用次数不可超过一次

onRejected 特性

如果 onRejected 是函数:

  • 当 promise 被拒绝执行后其必须被调用,其第一个参数为 promise 的据因
  • 在 promise 被拒绝执行前其不可被调用
  • 其调用次数不可超过一次

调用时机

onFulfilled 和 onRejected 只有在执行环境堆栈仅包含平台代码时才可被调用 注1

调用要求

onFulfilled 和 onRejected 必须被作为函数调用(即没有 this 值)[注2][2]

多次调用

then 方法可以被同一个 promise 调用多次

  • 当 promise 成功执行时,所有 onFulfilled 需按照其注册顺序依次回调
  • 当 promise 被拒绝执行时,所有的 onRejected 需按照其注册顺序依次回调

返回

then 方法必须返回一个 promise 对象 [注3][3]

1
promise2 = promise1.then(onFulfilled, onRejected);   
  • 如果 onFulfilled 或者 onRejected 返回一个值 x ,则运行下面的 Promise 解决过程:[[Resolve]](promise2, x)
  • 如果 onFulfilled 或者 onRejected 抛出一个异常 e ,则 promise2 必须拒绝执行,并返回拒因 e
  • 如果 onFulfilled 不是函数且 promise1 成功执行, promise2 必须成功执行并返回相同的值
  • 如果 onRejected 不是函数且 promise1 拒绝执行, promise2 必须拒绝执行并返回相同的据因

译者注:理解上面的“返回”部分非常重要,即:不论 promise1 被 reject 还是被 resolve 时 promise2都会被 resolve,只有出现异常时才会被 rejected。

Promise 解决过程

Promise 解决过程是一个抽象的操作,其需输入一个 promise 和一个值,我们表示为 [[Resolve]](promise, x),如果 x 有 then 方法且看上去像一个 Promise ,解决程序即尝试使 promise 接受 x 的状态;否则其用 x 的值来执行 promise 。

这种 thenable 的特性使得 Promise 的实现更具有通用性:只要其暴露出一个遵循 Promise/A+ 协议的 then方法即可;这同时也使遵循 Promise/A+ 规范的实现可以与那些不太规范但可用的实现能良好共存。

运行 [[Resolve]](promise, x) 需遵循以下步骤:

x 与 promise 相等

如果 promise 和 x 指向同一对象,以 TypeError 为据因拒绝执行 promise

x 为 Promise

如果 x 为 Promise ,则使 promise 接受 x 的状态 [注4][4]:

  • 如果 x 处于等待态, promise 需保持为等待态直至 x 被执行或拒绝
  • 如果 x 处于执行态,用相同的值执行 promise
  • 如果 x 处于拒绝态,用相同的据因拒绝 promise

x 为对象或函数

如果 x 为对象或者函数:

  • 把 x.then 赋值给 then [注5][5]

  • 如果取 x.then 的值时抛出错误 e ,则以 e 为据因拒绝 promise

  • 如果then是函数,将x作为函数的作用域this调用之。传递两个回调函数作为参数,第一个参数叫做

    resolvePromise,第二个参数叫做rejectPromise:

    • 如果 resolvePromise 以值 y 为参数被调用,则运行 [[Resolve]](promise, y)

    • 如果 rejectPromise 以据因 r 为参数被调用,则以据因 r 拒绝 promise

    • 如果 resolvePromise 和 rejectPromise 均被调用,或者被同一参数调用了多次,则优先采用首次调用并忽略剩下的调用

    • 如果调用then方法抛出了异常e:

      • 如果 resolvePromise 或 rejectPromise 已经被调用,则忽略之
      • 否则以 e 为据因拒绝 promise
    • 如果 then 不是函数,以 x 为参数执行 promise

  • 如果 x 不为对象或者函数,以 x 为参数执行 promise

如果一个 promise 被一个循环的 thenable 链中的对象解决,而 [[Resolve]](promise, thenable) 的递归性质又使得其被再次调用,根据上述的算法将会陷入无限递归之中。算法虽不强制要求,但也鼓励施者检测这样的递归是否存在,若检测到存在则以一个可识别的 TypeError 为据因来拒绝 promise [注6][6]。

注释


  • 注1 这里的平台代码指的是引擎、环境以及 promise 的实施代码。实践中要确保 onFulfilled 和 onRejected 方法异步执行,且应该在 then 方法被调用的那一轮事件循环之后的新执行栈中执行。这个事件队列可以采用“宏任务(macro-task)”机制或者“微任务(micro-task)”机制来实现。由于 promise 的实施代码本身就是平台代码(译者注:即都是 JavaScript),故代码自身在处理在处理程序时可能已经包含一个任务调度队列。

    译者注:这里提及了 macrotask 和 microtask 两个概念,这表示异步任务的两种分类。在挂起任务时,JS 引擎会将所有任务按照类别分到这两个队列中,首先在 macrotask 的队列(这个队列也被叫做 task queue)中取出第一个任务,执行完毕后取出 microtask 队列中的所有任务顺序执行;之后再取 macrotask 任务,周而复始,直至两个队列的任务都取完。

    两个类别的具体分类如下:

    • macro-task: script(整体代码), setTimeout, setInterval, setImmediate, I/O, UI rendering
    • micro-task: process.nextTick, Promises(这里指浏览器实现的原生 Promise), Object.observe, MutationObserver

    详见 stackoverflow 解答 或 这篇博客

  • 注2 也就是说在严格模式(strict)中,函数 this 的值为 undefined ;在非严格模式中其为全局对象。

  • 注3 代码实现在满足所有要求的情况下可以允许 promise2 === promise1 。每个实现都要文档说明其是否允许以及在何种条件下允许 promise2 === promise1 。

  • 注4 总体来说,如果 x 符合当前实现,我们才认为它是真正的 promise 。这一规则允许那些特例实现接受符合已知要求的 Promises 状态。

  • 注5 这步我们先是存储了一个指向 x.then 的引用,然后测试并调用该引用,以避免多次访问 x.then属性。这种预防措施确保了该属性的一致性,因为其值可能在检索调用时被改变。

  • 注6 实现不应该对 thenable 链的深度设限,并假定超出本限制的递归就是无限循环。只有真正的循环递归才应能导致 TypeError 异常;如果一条无限长的链上 thenable 均不相同,那么递归下去永远是正确的行为。

转载于 张鑫旭

简短总结

什么是层叠上下文

层叠上下文,英文称作”stacking context”. 是HTML中的一个三维的概念。简单来说就是一个容器,比普通元素高一个层级

如何产生一个层叠上下文

如何创建层叠上下文(MDN)

  1. 文档根元素(<html>);
  2. position 值为 absolute(绝对定位)或 relative(相对定位)且 z-index 值不为 auto 的元素;
  3. position 值为 fixed(固定定位)或 sticky(粘滞定位)的元素(沾滞定位适配所有移动设备上的浏览器,但老的桌面浏览器不支持);
  4. flex (flexbox) 容器的子元素,且 z-index 值不为 auto;
  5. grid (grid) 容器的子元素,且 z-index 值不为 auto;
  6. opacity 属性值小于 1 的元素(参见 the specification for opacity);
  7. mix-blend-mode 属性值不为 normal 的元素;
  8. 以下任意属性值不为none的元素:
  9. isolation 属性值为 isolate 的元素;
  10. -webkit-overflow-scrolling 属性值为 touch 的元素;
  11. will-change 值设定了任一属性而该属性在 non-initial 值时会创建层叠上下文的元素(参考这篇文章);
  12. contain 属性值为 layout、paint 或包含它们其中之一的合成值(比如 contain: strict、contain: content)的元素。

层叠上下文内部元素的顺序

更完整的7阶层叠顺序图

不同层叠上下文的层叠顺序

  1. 如果层叠上下文元素不依赖z-index数值,则其层叠顺序是z-index:auto可看成z:index:0级别;
  2. 如果层叠上下文元素依赖z-index数值,则其层叠顺序由z-index值决定。
  3. 后写的居上

拓展:层叠图层和复合图层有什么区别和联系呢

了解层

首先说明,这里讨论的是 WebKit,描述的是 Chrome 的实现细节,而并非是 web 平台的功能,因此这里介绍的内容不一定适用于其他浏览器。

  • Chrome 拥有两套不同的渲染路径(rendering path):硬件加速路径和旧软件路径(older software path)
  • Chrome 中有不同类型的层: RenderLayer(渲染层)和GraphicsLayer(图形层,也称复合图层),只有 GraphicsLayer 是作为纹理(texture)上传给GPU的。

浏览器中图层一般包含两大类:渲染图层(普通图层)以及复合图层

  • 渲染图层,是页面普通的文档流。我们虽然可以通过绝对定位,相对定位,浮动定位脱离文档流,但它仍然属于默认渲染图层,共用同一个绘图上下文对象(GraphicsContext)。
    • 满足形成层叠上下文条件的 LayoutObject 一定会为其创建新的独立的渲染层
  • 复合图层,又称图形层。它会单独分配系统资源,每个复合图层都有一个独立的GraphicsContext。(当然也会脱离普通文档流,这样一来,不管这个复合图层中怎么变化,也不会影响默认复合层里的回流重绘)

淘宝的文章描述的很清楚


以下是转载原文

在这个世界上,凡事都有个先后顺序,凡物都有个论资排辈。比方说食堂排队打饭,对吧,讲求先到先得,总不可能一拥而上。再比如说话语权,老婆的话永远是对的,领导的话永远是对的。

在CSS届,也是如此。只是,一般情况下,大家歌舞升平,看不出什么差异,即所谓的众生平等。但是,当发生冲突发生纠葛的时候,显然,是不可能做到完全等同的,先后顺序,身份差异就显现出来了。例如,杰克和罗斯,只能一人浮在木板上,此时,出现了冲突,结果大家都知道的。那对于CSS世界中的元素而言,所谓的“冲突”指什么呢,其中,很重要的一个层面就是“层叠显示冲突”。

默认情况下,网页内容是没有偏移角的垂直视觉呈现,当内容发生层叠的时候,一定会有一个前后的层叠顺序产生,有点类似于真实世界中论资排辈的感觉。

而要理解网页中元素是如何“论资排辈”的,就需要深入理解CSS中的层叠上下文和层叠顺序。

我们大家可能都熟悉CSS中的z-index属性,需要跟大家讲的是,z-index实际上只是CSS层叠上下文和层叠顺序中的一叶小舟。

一、什么是层叠上下文

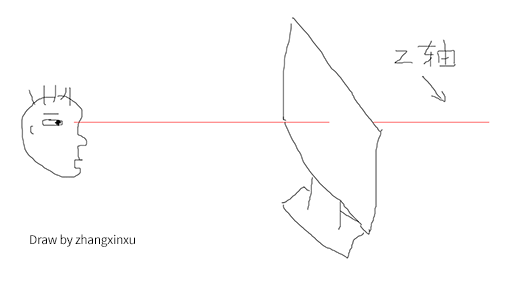
层叠上下文,英文称作”stacking context”. 是HTML中的一个三维的概念。如果一个元素含有层叠上下文,我们可以理解为这个元素在z轴上就“高人一等”。

这里出现了一个名词-z轴,指的是什么呢?

表示的是用户与屏幕的这条看不见的垂直线(参见下图示意-红线):
网页中z轴示意

层叠上下文是一个概念,跟「块状格式化上下文(BFC)」类似。然而,概念这个东西是比较虚比较抽象的,要想轻松理解,我们需要将其具象化。

怎么个具象化法呢?

你可以把「层叠上下文」理解为当官:网页中有很多很多的元素,我们可以看成是真实世界的芸芸众生。真实世界里,我们大多数人是普通老百姓们,还有一部分人是做官的官员。OK,这里的“官员”就可以理解为网页中的层叠上下文元素。

换句话说,页面中的元素有了层叠上下文,就好比我们普通老百姓当了官,一旦当了官,相比普通老百姓而言,离皇帝更近了,对不对,就等同于网页中元素级别更高,离我们用户更近了。

你懂的

二、什么是层叠水平

再来说说层叠水平。“层叠水平”英文称作”stacking level”,决定了同一个层叠上下文中元素在z轴上的显示顺序。level这个词很容易让我们联想到我们真正世界中的三六九等、论资排辈。真实世界中,每个人都是独立的个体,包括同卵双胞胎,有差异就有区分。例如,双胞胎虽然长得像Ctrl+C/Ctrl+V得到的,但实际上,出生时间还是有先后顺序的,先出生的那个就大,大哥或大姐。网页中的元素也是如此,页面中的每个元素都是独立的个体,他们一定是会有一个类似的排名排序的情况存在。而这个排名排序、论资排辈就是我们这里所说的“层叠水平”。层叠上下文元素的层叠水平可以理解为官员的职级,1品2品,县长省长之类;对于普通元素,这个嘛……你自己随意理解。

于是,显而易见,所有的元素都有层叠水平,包括层叠上下文元素,层叠上下文元素的层叠水平可以理解为官员的职级,1品2品,县长省长之类。然后,对于普通元素的层叠水平,我们的探讨仅仅局限在当前层叠上下文元素中。为什么呢?因为否则没有意义。

这么理解吧~ 上面提过元素具有层叠上下文好比当官,大家都知道的,这当官的家里都有丫鬟啊保镖啊管家啊什么的。所谓打狗看主人,A官员家里的管家和B官员家里的管家做PK实际上是没有意义的,因为他们牛不牛逼完全由他们的主子决定的。一人得道鸡犬升天,你说这和珅家里的管家和七侠镇娄知县县令家里的管家有可比性吗?李总理的秘书是不是分分钟灭了你村支部书记的秘书(如果有)。

翻译成术语就是:普通元素的层叠水平优先由层叠上下文决定,因此,层叠水平的比较只有在当前层叠上下文元素中才有意义。

你懂的

需要注意的是,诸位千万不要把层叠水平和CSS的z-index属性混为一谈。没错,某些情况下z-index确实可以影响层叠水平,但是,只限于定位元素以及flex盒子的孩子元素;而层叠水平所有的元素都存在。

三、什么是层叠顺序

再来说说层叠顺序。“层叠顺序”英文称作”stacking order”. 表示元素发生层叠时候有着特定的垂直显示顺序,注意,这里跟上面两个不一样,上面的层叠上下文和层叠水平是概念,而这里的层叠顺序是规则。

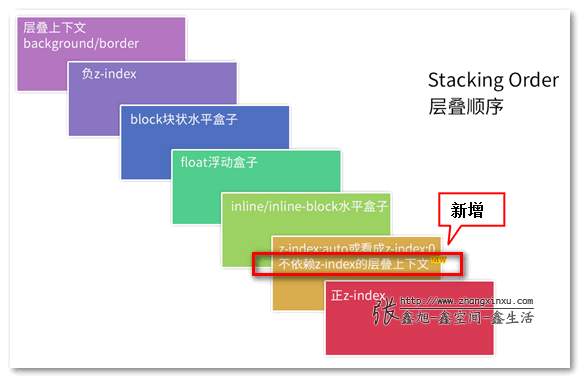
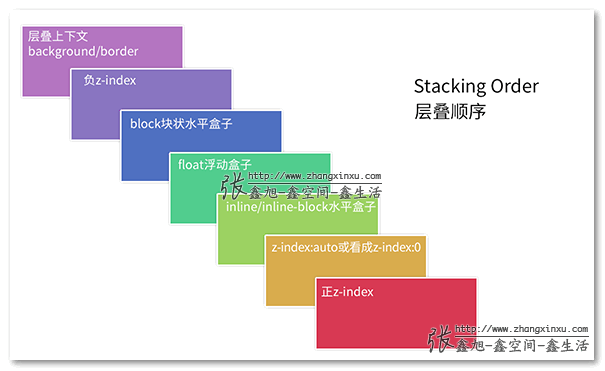
在CSS2.1的年代,在CSS3还没有出现的时候(注意这里的前提),层叠顺序规则遵循下面这张图:
层叠顺序

有人可能有见过类似图,那个图是很多很多年前老外绘制的,英文内容。而是更关键的是国内估计没有同行进行过验证与实践,实际上很多关键信息缺失。上面是我自己手动重绘的中文版同时补充很多其他地方绝对没有的重要知识信息。如果想要无水印高清大图,点击这里购买(0.5元)。

缺失的关键信息包括:

  1. 位于最低水平的border/background指的是层叠上下文元素的边框和背景色。每一个层叠顺序规则适用于一个完整的层叠上下文元素。
  2. 原图没有呈现inline-block的层叠顺序,实际上,inline-block和inline水平元素是同等level级别。
  3. z-index:0实际上和z-index:auto单纯从层叠水平上看,是可以看成是一样的。注意这里的措辞——“单纯从层叠水平上看”,实际上,两者在层叠上下文领域有着根本性的差异。

下面我要向大家发问了,大家有没有想过,为什么内联元素的层叠顺序要比浮动元素和块状元素都高?
疑问

为什么呢?我明明感觉浮动元素和块状元素要更屌一点啊。

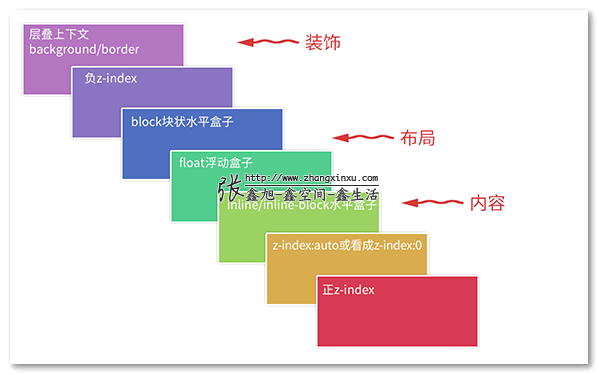
嘿嘿嘿,我就不卖关子了,直接看下图的标注说明:
层叠顺序元素的标注说明

诸如border/background一般为装饰属性,而浮动和块状元素一般用作布局,而内联元素都是内容。网页中最重要的是什么?当然是内容了哈,对不对!

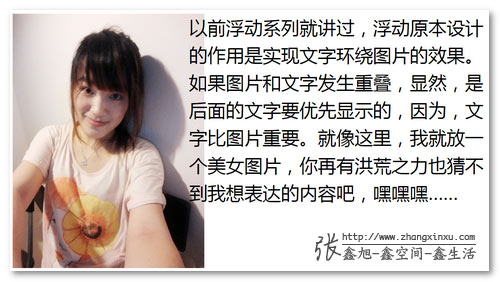
因此,一定要让内容的层叠顺序相当高,当发生层叠是很好,重要的文字啊图片内容可以优先暴露在屏幕上。例如,文字和浮动图片重叠的时候:

浮动和文字重叠

上面说的这些层叠顺序规则还是老时代的,如果把CSS3也牵扯进来,科科,事情就不一样了。

四、务必牢记的层叠准则

下面这两个是层叠领域的黄金准则。当元素发生层叠的时候,其覆盖关系遵循下面2个准则:

  1. 谁大谁上:当具有明显的层叠水平标示的时候,如识别的z-indx值,在同一个层叠上下文领域,层叠水平值大的那一个覆盖小的那一个。通俗讲就是官大的压死官小的。
  2. 后来居上:当元素的层叠水平一致、层叠顺序相同的时候,在DOM流中处于后面的元素会覆盖前面的元素。

在CSS和HTML领域,只要元素发生了重叠,都离不开上面这两个黄金准则。因为后面会有多个实例说明,这里就到此为止。

五、层叠上下文的特性

层叠上下文元素有如下特性:

  • 层叠上下文的层叠水平要比普通元素高(原因后面会说明);
  • 层叠上下文可以阻断元素的混合模式(见此文第二部分说明);
  • 层叠上下文可以嵌套,内部层叠上下文及其所有子元素均受制于外部的层叠上下文。
  • 每个层叠上下文和兄弟元素独立,也就是当进行层叠变化或渲染的时候,只需要考虑后代元素。
  • 每个层叠上下文是自成体系的,当元素发生层叠的时候,整个元素被认为是在父层叠上下文的层叠顺序中。

翻译成真实世界语言就是:

  • 当官的比老百姓更有机会面见圣上;
  • 领导下去考察,会被当地官员阻隔只看到繁荣看不到真实民情;
  • 一个家里,爸爸可以当官,孩子也是可以同时当官的。但是,孩子这个官要受爸爸控制。
  • 自己当官,兄弟不占光。有什么福利或者变故只会影响自己的孩子们。
  • 每个当官的都有属于自己的小团体,当家眷管家发生摩擦磕碰的时候(包括和其他官员的家眷管家),都是要优先看当官的也就是主子的脸色。

六、层叠上下文的创建

卖了这么多文字,到底层叠上下文是个什么鬼,倒是拿出来瞅瞅啊!

哈哈。如同块状格式化上下文,层叠上下文也基本上是有一些特定的CSS属性创建的。我将其总结为3个流派,也就是做官的3种途径:

  1. 皇亲国戚派:页面根元素天生具有层叠上下文,称之为“根层叠上下文”。
  2. 科考入选派:z-index值为数值的定位元素的传统层叠上下文。
  3. 其他当官途径:其他CSS3属性。

//zxx: 下面很多例子是实时CSS效果,建议您去原地址浏览,以便预览更准确的效果。

①. 根层叠上下文
指的是页面根元素,也就是滚动条的默认的始作俑者<html>元素。这就是为什么,绝对定位元素在left/top等值定位的时候,如果没有其他定位元素限制,会相对浏览器窗口定位的原因。

②. 定位元素与传统层叠上下文
对于包含有position:relative/position:absolute的定位元素,以及FireFox/IE浏览器(不包括Chrome等webkit内核浏览器)(目前,也就是2016年初是这样)下含有position:fixed声明的定位元素,当其z-index值不是auto的时候,会创建层叠上下文。

知道了这一点,有些现象就好理解了。

如下HTML代码:

1
2
3
4
5
6
<div style="position:relative; z-index:auto;">
<img src="mm1.jpg" style="position:absolute; z-index:2;"> <-- 横妹子 -->
</div>
<div style="position:relative; z-index:auto;">
<img src="mm2.jpg" style="position:relative; z-index:1;"> <-- 竖妹子 -->
</div>

img

img

大家会发现,竖着的妹子(mm2)被横着的妹子(mm1)给覆盖了。

下面,我们对父级简单调整下,把z-index:auto改成层叠水平一致的z-index:0, 代码如下:

1
2
3
4
5
6
<div style="position:relative; z-index:0;">
<img src="mm1.jpg" style="position:absolute; z-index:2;"> <-- 横妹子 -->
</div>
<div style="position:relative; z-index:0;">
<img src="mm2.jpg" style="position:relative; z-index:1;"> <-- 竖妹子 -->
</div>

img

img

大家会发现,尼玛反过来了,竖着的妹子(mm2)这回趴在了横着的妹子(mm1)身上。

百合大法好

为什么小小的改变会有想法的结果呢?
思考

差别就在于,z-index:0所在的<div>元素是层叠上下文元素,而z-index:auto所在的<div>元素是一个普通的元素,于是,里面的两个<img>妹子的层叠比较就不受父级的影响,两者直接套用层叠黄金准则,这里,两者有着明显不一的z-index值,因此,遵循“谁大谁上”的准则,于是,z-index为2的那个横妹子,就趴在了z-index为1的竖妹子身上。

而z-index一旦变成数值,哪怕是0,都会创建一个层叠上下文。此时,层叠规则就发生了变化。层叠上下文的特性里面最后一条——自成体系。两个<img>妹子的层叠顺序比较变成了优先比较其父级层叠上下文元素的层叠顺序。这里,由于两者都是z-index:0,层叠顺序这一块两者一样大,此时,遵循层叠黄金准则的另外一个准则“后来居上”,根据在DOM流中的位置决定谁在上面,于是,位于后面的竖着的妹子就自然而然趴在了横着的妹子身上。对,没错,<img>元素上的z-index打酱油了!

有时候,我们在网页重构的时候,会发现,z-index嵌套错乱,看看是不是受父级的层叠上下文元素干扰了。然后,可能没多大意义了,但我还是提一下,算是祭奠下,IE6/IE7浏览器有个bug,就是z-index:auto的定位元素也会创建层叠上下文。这就是为什么在过去,IE6/IE7的z-index会搞死人的原因。

然后,我再提一下position:fixed, 在过去,position:fixed和relative/absolute在层叠上下文这一块是一路货色,都是需要z-index为数值才行。但是,不知道什么时候起,Chrome等webkit内核浏览器,position:fixed元素天然层叠上下文元素,无需z-index为数值。根据我的测试,目前,IE以及FireFox仍是老套路。

③. CSS3与新时代的层叠上下文
CSS3的出现除了带来了新属性,同时还对过去的很多规则发出了挑战。例如,CSS3 transform对overflow隐藏对position:fixed定位的影响等。而这里,层叠上下文这一块的影响要更加广泛与显著。

如下:

  1. z-index值不为auto的flex项(父元素display:flex|inline-flex).
  2. 元素的opacity值不是1.
  3. 元素的transform值不是none.
  4. 元素mix-blend-mode值不是normal.
  5. 元素的filter值不是none.
  6. 元素的isolation值是isolate.
  7. will-change指定的属性值为上面任意一个。
  8. 元素的-webkit-overflow-scrolling设为touch.

基本上每一项都有很多槽点。

1. display:flex|inline-flex与层叠上下文
注意,这里的规则有些负责复杂。要满足两个条件才能形成层叠上下文:条件1是父级需要是display:flex或者display:inline-flex水平,条件2是子元素的z-index不是auto,必须是数值。此时,这个子元素为层叠上下文元素,没错,注意了,是子元素,不是flex父级元素。

眼见为实,给大家上例子吧。

如下HTML和CSS代码:

1
2
3
4
5
6
7
8
9
10
<div class="box">
<div>
<img src="mm1.jpg">
</div>
</div>
.box { }
.box > div { background-color: blue; z-index: 1; } /* 此时该div是普通元素,z-index无效 */
.box > div > img {
position: relative; z-index: -1; right: -150px; /* 注意这里是负值z-index */
}

结果如下:

img

会发现,妹子跑到蓝色背景的下面了。为什么呢?层叠顺序图可以找到答案,如下:
负值z-index的层叠顺序

从上图可以看出负值z-index的层叠顺序在block水平元素的下面,而蓝色背景div元素是个普通元素,因此,妹子直接穿越过去,在蓝色背景后面的显示了。

现在,我们CSS微调下,增加display:flex, 如下:

1
2
3
4
5
.box { display: flex; }
.box > div { background-color: blue; z-index: 1; } /* 此时该div是层叠上下文元素,同时z-index生效 */
.box > div > img {
position: relative; z-index: -1; right: -150px; /* 注意这里是负值z-index */
}

结果:

img

会发现,妹子在蓝色背景上面显示了,为什么呢?层叠顺序图可以找到答案,如下:
img

从上图可以看出负值z-index的层叠顺序在当前第一个父层叠上下文元素的上面,而此时,那个z-index值为1的蓝色背景<div>的父元素的display值是flex,一下子升官发财变成层叠上下文元素了,于是,图片在蓝色背景上面显示了。这个现象也证实了层叠上下文元素是flex子元素,而不是flex容器元素。

另外,另外,这个例子也颠覆了我们传统的对z-index的理解。在CSS2.1时代,z-index属性必须和定位元素一起使用才有作用,但是,在CSS3的世界里,非定位元素也能和z-index愉快地搞基。

2. opacity与层叠上下文
我们直接看代码,原理和上面例子一样,就不解释了。

如下HTML和CSS代码:

1
2
3
4
5
6
7
<div class="box">
<img src="mm1.jpg">
</div>
.box { background-color: blue; }
.box > img {
position: relative; z-index: -1; right: -150px;
}

结果如下:

img

然后价格透明度,例如50%透明:

1
2
3
4
.box { background-color: blue; opacity: 0.5;  }
.box > img {
position: relative; z-index: -1; right: -150px;
}

结果如下:

img

原因就是半透明元素具有层叠上下文,妹子图片的z-index:-1无法穿透,于是,在蓝色背景上面乖乖显示了。

3. transform与层叠上下文
应用了transform变换的元素同样具有菜单上下文。

我们直接看应用后的结果,如下CSS代码:

1
2
3
4
.box { background-color: blue; transform: rotate(15deg);  }
.box > img {
position: relative; z-index: -1; right: -150px;
}

结果如下:

img

妹子同样在蓝色背景之上。

4. mix-blend-mode与层叠上下文
mix-blend-mode类似于PS中的混合模式,之前专门有文章介绍-“CSS3混合模式mix-blend-mode简介”。

元素和白色背景混合。无论哪种模式,要么全白,要么没有任何变化。为了让大家有直观感受,因此,下面例子我特意加了个原创平铺背景:

1
2
3
4
.box { background-color: blue; mix-blend-mode: darken;  }
.box > img {
position: relative; z-index: -1; right: -150px;
}

结果如下:

img

需要注意的是,目前,IE浏览器(包括IE14)还不支持mix-blend-mode,因此,要想看到妹子在背景色之上,请使用Chrome或FireFox。

同样的,因为蓝色背景元素升级成了层叠上下文,因此,z-index:-1无法穿透,在蓝色背景上显示了。

5. filter与层叠上下文
此处说的filter是CSS3中规范的滤镜,不是旧IE时代私有的那些,虽然目的类似。同样的,我之前有提过,例如图片的灰度或者图片的毛玻璃效果等。

我们使用常见的模糊效果示意下:

1
2
3
4
.box { background-color: blue; filter: blur(5px);  }
.box > img {
position: relative; z-index: -1; right: -150px;
}

结果如下:

img

好吧,果然被你猜对了,妹子蓝色床上躺着,只是你眼镜摘了,看得有些不够真切罢了。

6. isolation:isolate与层叠上下文
isolation:isolate这个声明是mix-blend-mode应运而生的。默认情况下,mix-blend-mode会混合z轴所有层叠在下面的元素,要是我们不希望某个层叠的元素参与混合怎么办呢?就是使用isolation:isolate。由于一言难尽,我特意为此写了篇文章:“理解CSS3 isolation: isolate的表现和作用”,解释了其阻隔混合模式的原理,建议大家看下。

要演示这个效果,我需要重新设计下,如下HTML结构:

1
2
3
4
<img src="img/mm2.jpg" class="mode">
<div class="box">
<img src="mm1.jpg">
</div>

CSS主要代码如下:

1
2
3
4
5
6
7
8
9
10
.mode {
/* 竖妹子绝对定位,同时混合模式 */
position: absolute; mix-blend-mode: darken;
}
.box {
background: blue;
}
.box > img {
position: relative; z-index: -1;
}

结构如下:

img

img

会发现,横妹子被混合模式了。此时,我们给妹子所在容器增加isolation:isolate,如下CSS所示:

1
2
3
4
5
6
7
8
9
10
.mode {
/* 竖妹子绝对定位,同时混合模式 */
position: absolute; mix-blend-mode: darken;
}
.box {
background: blue; isolation:isolate;
}
.box > img {
position: relative; z-index: -1;
}

结果为:

img

img

会发现横着的妹子跑到蓝色背景上面了。这表明确实创建了层叠上下文。

7. will-change与层叠上下文
关于will-change,如果有同学还不了解,可以参见我之前写的文章:“使用CSS3 will-change提高页面滚动、动画等渲染性能”。

都是类似的演示代码:

1
2
3
4
.box { background-color: blue; will-change: transform;  }
.box > img {
position: relative; z-index: -1; right: -150px;
}

结果如下:

img

果然不出所料,妹子上了蓝色的背景。

七、层叠上下文与层叠顺序

本文多次提到,一旦普通元素具有了层叠上下文,其层叠顺序就会变高。那它的层叠顺序究竟在哪个位置呢?

这里需要分两种情况讨论:

  1. 如果层叠上下文元素不依赖z-index数值,则其层叠顺序是z-index:auto可看成z:index:0级别;
  2. 如果层叠上下文元素依赖z-index数值,则其层叠顺序由z-index值决定。

于是乎,我们上面提供的层叠顺序表,实际上还是缺少其他重要信息。我又花功夫重新绘制了一个更完整的7阶层叠顺序图(同样的版权所有,商业请购买,可得无水印大图):

更完整的7阶层叠顺序图

大家知道为什么定位元素会层叠在普通元素的上面吗?

其根本原因就在于,元素一旦成为定位元素,其z-index就会自动生效,此时其z-index就是默认的auto,也就是0级别,根据上面的层叠顺序表,就会覆盖inline或block或float元素。

而不支持z-index的层叠上下文元素天然z-index:auto级别,也就意味着,层叠上下文元素和定位元素是一个层叠顺序的,于是当他们发生层叠的时候,遵循的是“后来居上”准则。

我们可以速度测试下:

1
2
3
4
<img src="mm1" style="position:relative">
<img src="mm2" style="transform:scale(1);">
<img src="mm1" style="position:relative">

imgimg
imgimg

会发现,两者样式一模一样,仅仅是在DOM流中的位置不一样,导致他们的层叠表现不一样,后面的妹子趴在了前面妹子的身上。这也说明了,层叠上下文元素的层叠顺序就是z-index:auto级别。

z-index值与层叠顺序
如果元素支持z-index值,则层叠顺序就要好理解些了,比较数值大小嘛,小盆友都会,本质上是应用的“谁大谁上”的准则。在以前,我们只需要关心定位元素的z-index就好,但是,在CSS3时代,flex子项也支持z-index,使得我们面对的情况比以前要负复杂。然而,好的是,规则都是一样的,对于z-index的使用和表现也是如此,套用上面的7阶层叠顺序表就可以了。

同样,举个简单例子,看下z-index:-1和z-index:1变化对层叠表现的影响,如下两段HTML:

1
2
3
4
5
6
<div style="display:flex; background:blue;">
<img src="mm1.jpg" style="z-index:-1;">
</div>
<div style="display:flex; background:blue;">
<img src="mm1.jpg" style="z-index:1;">
</div>

最后,会发现,z-index:-1跑到了背景色小面,而z-index:1高高在上。

img

img

一个与层叠上下文相关的有趣的显示现象
在实际项目中,我们可能会渐进使用CSS3的fadeIn淡入animation效果增强体验,于是,我们可能就会遇到类似下面的现象:

您可以狠狠地点击这里:CSS3 fadeIn淡入animation动画有趣现象

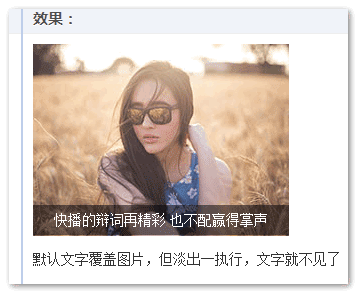
有一个绝对定位的黑色半透明层覆盖在图片上,默认显示是这样的:

文字在妹子上

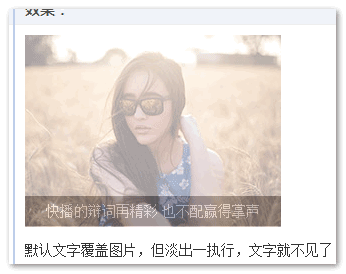
但是,一旦图片开始走fadeIn淡出的CSS3动画,文字跑到图片后面去了img:

文字跑到图片后面

为什么会这样?

实际上,学了本文的内容,就很简单了!fadeIn动画本质是opacity透明度的变化:

1
2
3
4
5
6
7
8
@keyframes fadeIn {
0% {
opacity: 0;
}
100% {
opacity: 1;
}
}

要知道,opacity的值不是1的时候,是具有层叠上下文的,层叠顺序是z-index:auto级别,跟没有z-index值的absolute绝对定位元素是平起平坐的。而本demo中的文字元素在图片元素的前面,于是,当CSS3动画只要不是最终一瞬间的opacity: 1,位于DOM流后面的图片就会遵循“后来居上”准则,覆盖文字。

这就是原因,于是,我们想要解决这个问题就很简单。

\1. 调整DOM流的先后顺序;
\2. 提高文字的层叠顺序,例如,设置z-index:1;

八、结束语

只要元素发生层叠,要解释其表现,基本上就本文的这些内容了。

我发现很多重构小伙伴都有z-index滥用,或者使用不规范的问题。我觉得最主要的原因还是对理解层叠上下文以及层叠顺序这些概念都不了解。例如,只要使用了定位元素,尤其absolute绝对定位,都离不开设置一个z-index值;或者只要元素被其他元素覆盖了,例如变成定位元素或者增加z-index值升级。页面一复杂,必然搞得乱七八糟。

实际上,在我看来,觉得多数常见,z-index根本就没有出现的必要。知道了内联元素的层叠水平比块状元素高,于是,某条线你想覆盖上去的时候,需要设置position:relative吗?不需要,inline-block化就可以。因为IE6/IE7 position:relative会创建层叠上下文,很烦的。

OK,本文已经够长了,就不多啰嗦了。
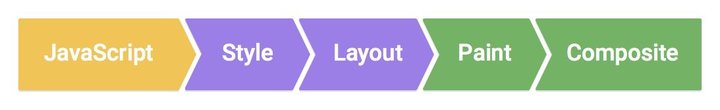
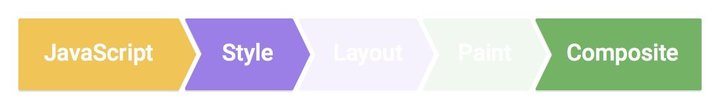
一个 Web 页面的展示,简单来说可以认为经历了以下下几个步骤。

img

  • JavaScript:一般来说,我们会使用 JavaScript 来实现一些视觉变化的效果。比如做一个动画或者往页面里添加一些 DOM 元素等。

  • Style:计算样式,这个过程是根据 CSS 选择器,对每个 DOM 元素匹配对应的 CSS 样式。这一步结束之后,就确定了每个 DOM 元素上该应用什么 CSS 样式规则。

  • Layout:布局,上一步确定了每个 DOM 元素的样式规则,这一步就是具体计算每个 DOM 元素最终在屏幕上显示的大小和位置。web 页面中元素的布局是相对的,因此一个元素的布局发生变化,会联动地引发其他元素的布局发生变化。比如,<body> 元素的宽度的变化会影响其子元素的宽度,其子元素宽度的变化也会继续对其孙子元素产生影响。因此对于浏览器来说,布局过程是经常发生的。

  • Paint:绘制,本质上就是填充像素的过程。包括绘制文字、颜色、图像、边框和阴影等,也就是一个 DOM 元素所有的可视效果。一般来说,这个绘制过程是在多个层上完成的。

  • Composite:渲染层合并,由上一步可知,对页面中 DOM 元素的绘制是在多个层上进行的。在每个层上完成绘制过程之后,浏览器会将所有层按照合理的顺序合并成一个图层,然后显示在屏幕上。对于有位置重叠的元素的页面,这个过程尤其重要,因为一旦图层的合并顺序出错,将会导致元素显示异常。

当然,本文我们只来关注 Composite 部分。

浏览器渲染原理

在讨论 Composite 之前,有必要先简单了解下一些浏览器(本文只是针对 Chrome 来说)的渲染原理,方便对之后一些概念的理解。更多详细的内容可以参阅 GPU Accelerated Compositing in Chrome

注:由于 Chrome 对 Blank 引擎某些实现的修改,某些我们之前熟知的类名有了变化,比如 RenderObject 变成了 LayoutObject,RenderLayer 变成了 PaintLayer。感兴趣的看以参阅 Slimming Paint。

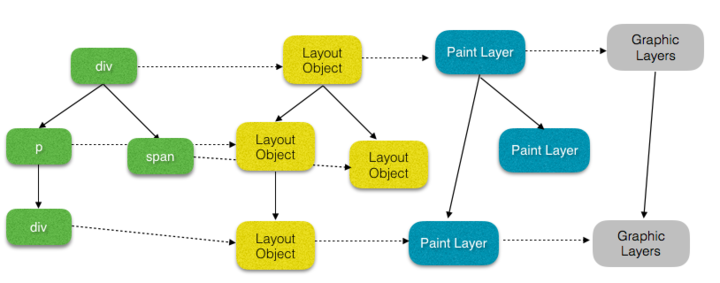
在浏览器中,页面内容是存储为由 Node 对象组成的树状结构,也就是 DOM 树。每一个 HTML element 元素都有一个 Node 对象与之对应,DOM 树的根节点永远都是 Document Node。这一点相信大家都很熟悉了,但其实,从 DOM 树到最后的渲染,需要进行一些转换映射。

img

从 Nodes 到 LayoutObjects

DOM 树中得每个 Node 节点都有一个对应的 LayoutObject 。LayoutObject 知道如何在屏幕上 paint Node 的内容。

从 LayoutObjects 到 PaintLayers

一般来说,拥有相同的坐标空间的 LayoutObjects,属于同一个渲染层(PaintLayer)。PaintLayer 最初是用来实现 stacking contest(层叠上下文),以此来保证页面元素以正确的顺序合成(composite),这样才能正确的展示元素的重叠以及半透明元素等等。因此满足形成层叠上下文条件的 LayoutObject 一定会为其创建新的渲染层,当然还有其他的一些特殊情况,为一些特殊的 LayoutObjects 创建一个新的渲染层,比如 overflow != visible 的元素。根据创建 PaintLayer 的原因不同,可以将其分为常见的 3 类:

  • NormalPaintLayer

  • 根元素(HTML)

  • 有明确的定位属性(relative、fixed、sticky、absolute)

  • 透明的(opacity 小于 1)

  • 有 CSS 滤镜(fliter)

  • 有 CSS mask 属性

  • 有 CSS mix-blend-mode 属性(不为 normal)

  • 有 CSS transform 属性(不为 none)

  • backface-visibility 属性为 hidden

  • 有 CSS reflection 属性

  • 有 CSS column-count 属性(不为 auto)或者 有 CSS column-width 属性(不为 auto)

  • 当前有对于 opacity、transform、fliter、backdrop-filter 应用动画

  • OverflowClipPaintLayer

  • overflow 不为 visible

  • NoPaintLayer

  • 不需要 paint 的 PaintLayer,比如一个没有视觉属性(背景、颜色、阴影等)的空 div。

满足以上条件的 LayoutObject 会拥有独立的渲染层,而其他的 LayoutObject 则和其第一个拥有渲染层的父元素共用一个。

从 PaintLayers 到 GraphicsLayers

某些特殊的渲染层会被认为是合成层(Compositing Layers),合成层拥有单独的 GraphicsLayer,而其他不是合成层的渲染层,则和其第一个拥有 GraphicsLayer 父层公用一个。

每个 GraphicsLayer 都有一个 GraphicsContext,GraphicsContext 会负责输出该层的位图,位图是存储在共享内存中,作为纹理上传到 GPU 中,最后由 GPU 将多个位图进行合成,然后 draw 到屏幕上,此时,我们的页面也就展现到了屏幕上。

渲染层提升为合成层的原因有一下几种:

注:渲染层提升为合成层有一个先决条件,该渲染层必须是 SelfPaintingLayer(基本可认为是上文介绍的 NormalPaintLayer)。以下所讨论的渲染层提升为合成层的情况都是在该渲染层为 SelfPaintingLayer 前提下的。

  • 直接原因(direct reason)

  • 硬件加速的 iframe 元素(比如 iframe 嵌入的页面中有合成层)demo

  • video 元素

  • 覆盖在 video 元素上的视频控制栏

  • 3D 或者 硬件加速的 2D Canvas 元素

  • demo:普通 2D Canvas 不会提升为合成层

  • demo:3D Canvas 提升为合成层

  • 硬件加速的插件,比如 flash 等等

  • 在 DPI 较高的屏幕上,fix 定位的元素会自动地被提升到合成层中。但在 DPI 较低的设备上却并非如此,因为这个渲染层的提升会使得字体渲染方式由子像素变为灰阶(详细内容请参考:Text Rendering)

  • 有 3D transform

  • backface-visibility 为 hidden

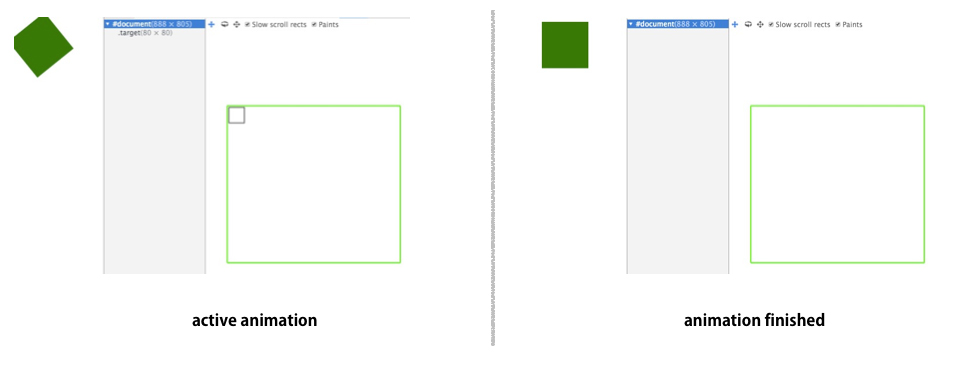
  • 对 opacity、transform、fliter、backdropfilter 应用了 animation 或者 transition(需要是 active 的 animation 或者 transition,当 animation 或者 transition 效果未开始或结束后,提升合成层也会失效)

  • demo:animation

  • demo:transition

img

  • will-change 设置为 opacity、transform、top、left、bottom、right(其中 top、left 等需要设置明确的定位属性,如 relative 等)demo

  • 后代元素原因

  • 有合成层后代同时本身有 transform、opactiy(小于 1)、mask、fliter、reflection 属性 demo

  • 有合成层后代同时本身 overflow 不为 visible(如果本身是因为明确的定位因素产生的 SelfPaintingLayer,则需要 z-index 不为 auto) demo

  • 有合成层后代同时本身 fixed 定位 demo

  • 有 3D transfrom 的合成层后代同时本身有 preserves-3d 属性 demo

  • 有 3D transfrom 的合成层后代同时本身有 perspective 属性 demo

  • overlap 重叠原因
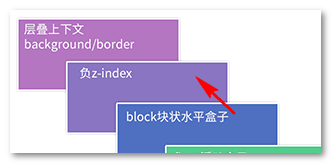
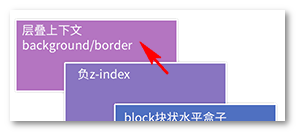
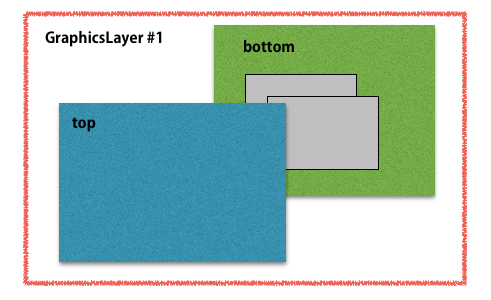
    为什么会因为重叠原因而产生合成层呢?举个简单的栗子。
    img
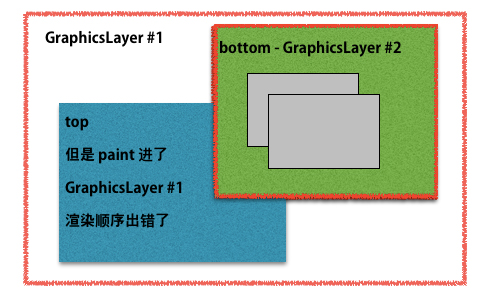
    蓝色的矩形重叠在绿色矩形之上,同时它们的父元素是一个 GraphicsLayer。此时假设绿色矩形为一个 GraphicsLayer,如果 overlap 无法提升合成层的话,那么蓝色矩形不会提升为合成层,也就会和父元素公用一个 GraphicsLayer。
    img
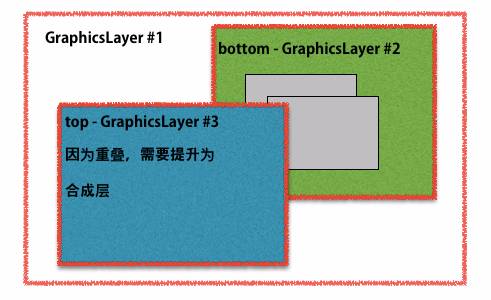
    此时,渲染顺序就会发生错误,因此为保证渲染顺序,overlap 也成为了合成层产生的原因,也就是如下的正常情形。
    img
    当然 overlap 的原因也会细分为几类,接下来我们会详细看下。

  • 重叠或者说部分重叠在一个合成层之上。
    那如何算是重叠呢,最常见和容易理解的就是元素的 border box(content + padding + border) 和合成层的有重叠,比如:demo,当然 margin area 的重叠是无效的(demo)。其他的还有一些不常见的情况,也算是同合成层重叠的条件,如下:

  • filter 效果同合成层重叠 demo

  • transform 变换后同合成层重叠 demo

  • overflow scroll 情况下同合成层重叠。即如果一个 overflow scroll(不管 overflow:auto 还是 overflow:scrill,只要是能 scroll 即可) 的元素同一个合成层重叠,则其可视子元素也同该合成层重叠 demo

  • 假设重叠在一个合成层之上(assumedOverlap)。
    这个原因听上去有点虚,什么叫假设重叠?其实也比较好理解,比如一个元素的 CSS 动画效果,动画运行期间,元素是有可能和其他元素有重叠的。针对于这种情况,于是就有了 assumedOverlap 的合成层产生原因,示例可见:demo。在本 demo 中,动画元素视觉上并没有和其兄弟元素重叠,但因为 assumedOverlap 的原因,其兄弟元素依然提升为了合成层。
    需要注意的是该原因下,有一个很特殊的情况:
    如果合成层有内联的 transform 属性,会导致其兄弟渲染层 assume overlap,从而提升为合成层。比如:demo。

层压缩

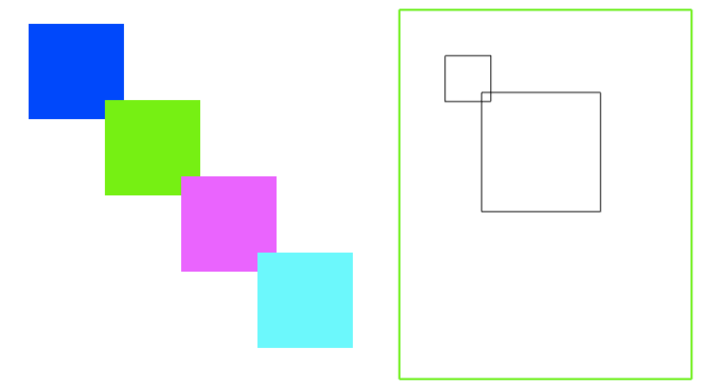
基本上常见的一些合成层的提升原因如上所说,你会发现,由于重叠的原因,可能随随便便就会产生出大量合成层来,而每个合成层都要消耗 CPU 和内存资源,岂不是严重影响页面性能。这一点浏览器也考虑到了,因此就有了层压缩(Layer Squashing)的处理。如果多个渲染层同一个合成层重叠时,这些渲染层会被压缩到一个 GraphicsLayer 中,以防止由于重叠原因导致可能出现的“层爆炸”。具体可以看如下 demo。一开始,蓝色方块由于
translateZ 提升为了合成层,其他的方块元素因为重叠的原因,被压缩了一起,大小就是包含这 3 个方块的矩形大小。

img

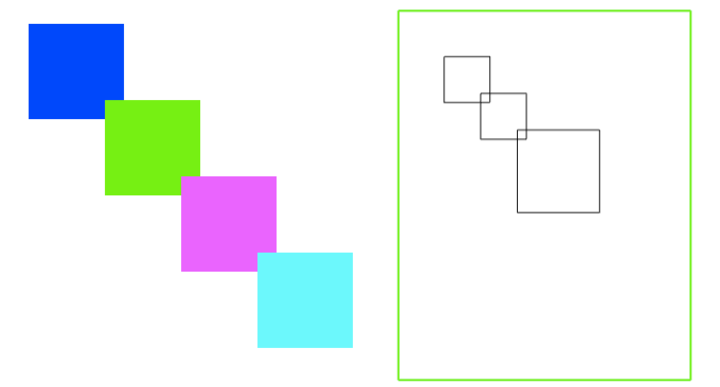
当我们 hover 绿色方块时,会给其设置 translateZ 属性,导致绿色方块也被提升为合成层,则剩下的两个被压缩到了一起,大小就缩小为包含这 2 个方块的矩形大小。

img

当然,浏览器的自动的层压缩也不是万能的,有很多特定情况下,浏览器是无法进行层压缩的,如下所示,而这些情况也是我们应该尽量避免的。(注:以下情况都是基于重叠原因而言)

  • 无法进行会打破渲染顺序的压缩(squashingWouldBreakPaintOrder)

    示例如下:

    demo

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    <style>
    #ancestor {
    -webkit-mask-image: -webkit-linear-gradient(rgba(0,0,0,1), rgba(0,0,0,0));
    }

    #composited {
    width: 100%;
    height: 100%;
    transform: translateZ(0);
    }

    #container {
    position: relative;
    width: 400px;
    height: 60px;
    border: 1px solid black;
    }

    #overlap-child {
    position: absolute;
    left: 0;
    top: 0 ;
    bottom: 0px;
    width: 100%;
    height: 60px;
    background-color: orange;
    }
    </style>

    <div id="container">
    <div id="composited">Text behind the orange box.</div>
    <div id="ancestor">
    <div id="overlap-child"></div>
    </div>
    </div>

    在本例中,

    1
    #overlap-child

    同合成层重叠,如果进行压缩,会导致渲染顺序的改变,其父元素

    1
    #ancestor

    的 mask 属性将失效,因此类似这种情况下,是无法进行层压缩的。目前常见的产生这种原因的情况有两种,一种是上述的祖先元素使用 mask 属性的情况,另一种是祖先元素使用 filter 属性的情况(

    demo

    )。

  • video 元素的渲染层无法被压缩同时也无法将别的渲染层压缩到 video 所在的合成层上(squashingVideoIsDisallowed)demo

  • iframe、plugin 的渲染层无法被压缩同时也无法将别的渲染层压缩到其所在的合成层上(squashingLayoutPartIsDisallowed)demo

  • 无法压缩有 reflection 属性的渲染层(squashingReflectionDisallowed)demo

  • 无法压缩有 blend mode 属性的渲染层(squashingBlendingDisallowed)demo

  • 当渲染层同合成层有不同的裁剪容器(clipping container)时,该渲染层无法压缩(squashingClippingContainerMismatch)。

    示例如下:

    demo

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    <style>
    .clipping-container {

    overflow: hidden;
    height: 10px;
    background-color: blue;
    }

    .composited {

    transform: translateZ(0);
    height: 10px;
    background-color: red;
    }

    .target {

    position:absolute;
    top: 0px;
    height:100px;
    width:100px;
    background-color: green;
    color: #fff;
    }
    </style>

    <div class="clipping-container">
    <div class="composited"></div>
    </div>
    <div class="target">不会被压缩到 composited div 上</div>

    本例中

    1
    .target

    同 合成层

    1
    .composited

    重叠,但是由于

    1
    .composited

    在一个

    1
    overflow: hidden

    的容器中,导致

    1
    .target

    和合成层有不同的裁剪容器,从而

    1
    .target

    无法被压缩。

  • 相对于合成层滚动的渲染层无法被压缩(scrollsWithRespectToSquashingLayer)

    示例如下:

    demo

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    <style>
    body {
    height: 1500px;
    overflow-x: hidden;
    }

    .composited {

    width: 50px;
    height: 50px;
    background-color: red;
    position: absolute;
    left: 50px;
    top: 400px;
    transform: translateZ(0);
    }

    .overlap {
    width: 200px;
    height: 200px;
    background-color: green;
    position: fixed;
    left: 0px;
    top: 0px;
    }
    </style>

    <div class="composited"></div>
    <div class="overlap"></div>

    本例中,红色的

    1
    .composited

    提升为了合成层,绿色的

    1
    .overlap

    fix 在页面顶部,一开始只有

    1
    .composited

    合成层。

    当滑动页面,

    1
    .overlap

    重叠到

    1
    .composited

    上时,

    1
    .overlap

    会因重叠原因提升为合成层,同时,因为相对于合成层滚动,因此无法被压缩。

  • 当渲染层同合成层有不同的具有 opacity 的祖先层(一个设置了 opacity 且小于 1,一个没有设置 opacity,也算是不同)时,该渲染层无法压缩(squashingOpacityAncestorMismatch,同 squashingClippingContainerMismatch)demo

  • 当渲染层同合成层有不同的具有 transform 的祖先层时,该渲染层无法压缩(squashingTransformAncestorMismatch,同上) demo

  • 当渲染层同合成层有不同的具有 filter 的祖先层时,该渲染层无法压缩(squashingFilterAncestorMismatch,同上)demo

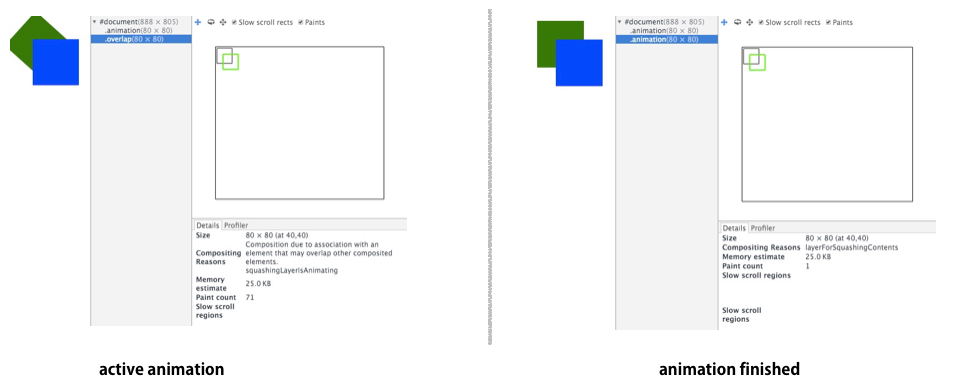
  • 当覆盖的合成层正在运行动画时,该渲染层无法压缩(squashingLayerIsAnimating),当动画未开始或者运行完毕以后,该渲染层才可以被压缩 demo
    img

如何查看合成层

使用 Chrome DevTools 工具来查看页面中合成层的情况。

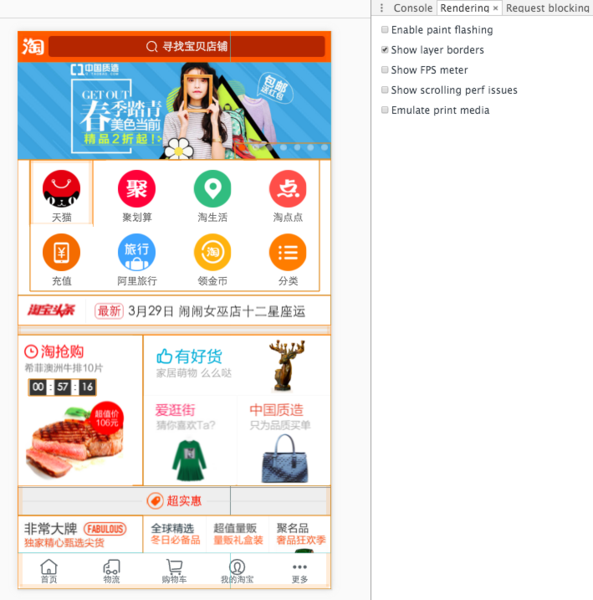
比较简单的方法是打开 DevTools,勾选上 Show layer borders

img

其中,页面上的合成层会用黄色边框框出来。

img

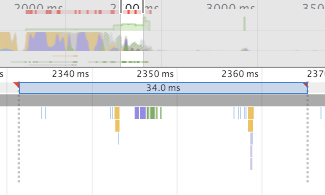
当然,更加详细的信息可以通过 Timeline 来查看。

每一个单独的帧,看到每个帧的渲染细节:

img

点击之后,你就会在视图中看到一个新的选项卡:Layers。

img

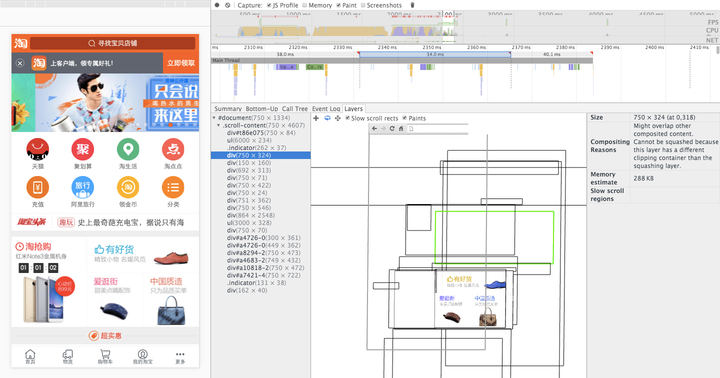
点击这个 Layers 选项卡,你会看到一个新的视图。在这个视图中,你可以对这一帧中的所有合成层进行扫描、缩放等操作,同时还能看到每个渲染层被创建的原因。

img

有了这个视图,你就能知道页面中到底有多少个合成层。如果你在对页面滚动或渐变效果的性能分析中发现 Composite 过程耗费了太多时间,那么你可以从这个视图里看到页面中有多少个渲染层,它们为何被创建,从而对合成层的数量进行优化。

性能优化

提升为合成层简单说来有以下几点好处:

  • 合成层的位图,会交由 GPU 合成,比 CPU 处理要快

  • 当需要 repaint 时,只需要 repaint 本身,不会影响到其他的层

  • 对于 transform 和 opacity 效果,不会触发 layout 和 paint

利用合成层对于提升页面性能方面有很大的作用,因此我们也总结了一下几点优化建议。

提升动画效果的元素

合成层的好处是不会影响到其他元素的绘制,因此,为了减少动画元素对其他元素的影响,从而减少 paint,我们需要把动画效果中的元素提升为合成层。

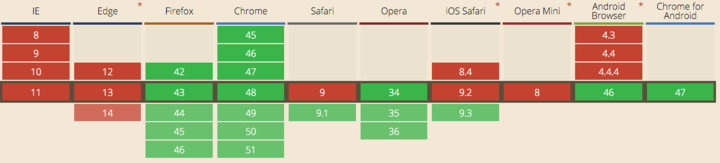
提升合成层的最好方式是使用 CSS 的 will-change 属性。从上一节合成层产生原因中,可以知道 will-change 设置为 opacity、transform、top、left、bottom、right 可以将元素提升为合成层。

1
2
3
#target {
will-change: transform;
}

其兼容如下所示:

img

对于那些目前还不支持 will-change 属性的浏览器,目前常用的是使用一个 3D transform 属性来强制提升为合成层:

1
2
3
#target {
transform: translateZ(0);
}

但需要注意的是,不要创建太多的渲染层。因为每创建一个新的渲染层,就意味着新的内存分配和更复杂的层的管理。之后我们会详细讨论。

如果你已经把一个元素放到一个新的合成层里,那么可以使用 Timeline 来确认这么做是否真的改进了渲染性能。别盲目提升合成层,一定要分析其实际性能表现。

使用 transform 或者 opacity 来实现动画效果

文章最开始,我们讲到了页面呈现出来所经历的渲染流水线,其实从性能方面考虑,最理想的渲染流水线是没有布局和绘制环节的,只需要做合成层的合并即可:

img

为了实现上述效果,就需要只使用那些仅触发 Composite 的属性。目前,只有两个属性是满足这个条件的:transforms 和 opacity。更详细的信息可以查看 CSS Triggers。

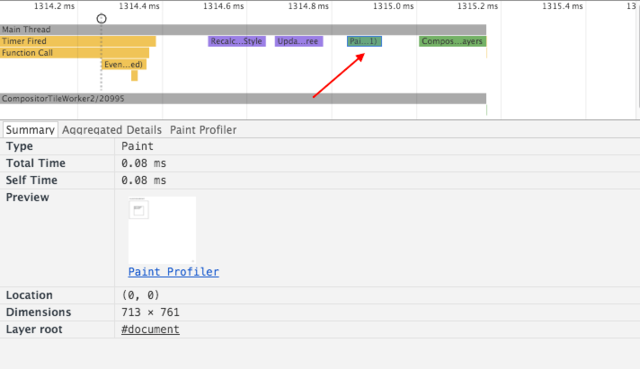
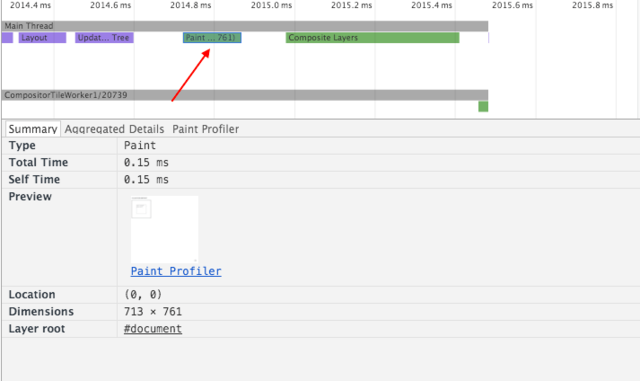
注意:元素提升为合成层后,transform 和 opacity 才不会触发 paint,如果不是合成层,则其依然会触发 paint。具体见如下两个 demo。

可以看到未提升 target element 为合成层,transform 和 opacity 依然会触发 paint。

减少绘制区域

对于不需要重新绘制的区域应尽量避免绘制,以减少绘制区域,比如一个 fix 在页面顶部的固定不变的导航 header,在页面内容某个区域 repaint 时,整个屏幕包括 fix 的 header 也会被重绘,见 demo,结果如下:

img

而对于固定不变的区域,我们期望其并不会被重绘,因此可以通过之前的方法,将其提升为独立的合成层。

减少绘制区域,需要仔细分析页面,区分绘制区域,减少重绘区域甚至避免重绘。

合理管理合成层

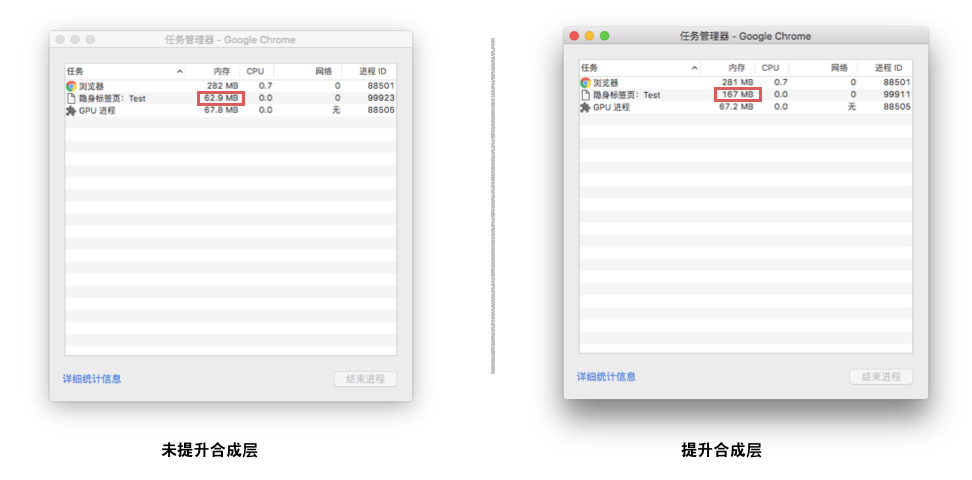
看完上面的文章,你会发现提升合成层会达到更好的性能。这看上去非常诱人,但是问题是,创建一个新的合成层并不是免费的,它得消耗额外的内存和管理资源。实际上,在内存资源有限的设备上,合成层带来的性能改善,可能远远赶不上过多合成层开销给页面性能带来的负面影响。同时,由于每个渲染层的纹理都需要上传到 GPU 处理,因此我们还需要考虑 CPU 和 GPU 之间的带宽问题、以及有多大内存供 GPU 处理这些纹理的问题。

对于合成层占用内存的问题,我们简单做了几个 demo 进行了验证。

demo 1 和 demo 2 中,会创建 2000 个同样的 div 元素,不同的是 demo 2 中的元素通过 will-change 都提升为了合成层,而两个 demo 页面的内存消耗却有很明显的差别。

img

防止层爆炸

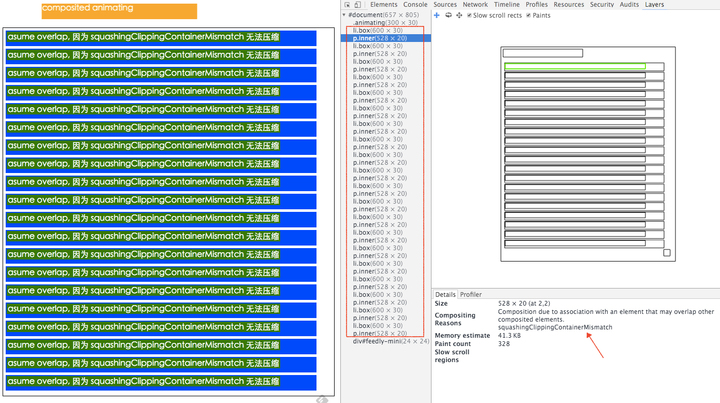
通过之前的介绍,我们知道同合成层重叠也会使元素提升为合成层,虽然有浏览器的层压缩机制,但是也有很多无法进行压缩的情况。也就是说除了我们显式的声明的合成层,还可能由于重叠原因不经意间产生一些不在预期的合成层,极端一点可能会产生大量的额外合成层,出现层爆炸的现象。我们简单写了一个极端点但其实在我们的页面中比较常见的 demo。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
<style>
@-webkit-keyframes slide {
from { transform: none; }
to { transform: translateX(100px); }
}
.animating {

width: 300px;
height: 30px;
background-color: orange;
color: #fff;
-webkit-animation: slide 5s alternate linear infinite;
}

ul {

padding: 5px;
border: 1px solid #000;
}

.box {

width: 600px;
height: 30px;
margin-bottom: 5px;
background-color: blue;
color: #fff;
position: relative;
/* 会导致无法压缩:squashingClippingContainerMismatch */
overflow: hidden;
}

.inner {
position: absolute;
top: 2px;
left: 2px;
font-size: 16px;
line-height: 16px;
padding: 2px;
margin: 0;
background-color: green;
}
</style>

<!-- 动画合成层 -->
<div class="animating">composited animating</div>
<ul>
<!-- assume overlap -->
<li class="box">
<!-- assume overlap -->
<p class="inner">asume overlap, 因为 squashingClippingContainerMismatch 无法压缩</p>
</li>

...
</ul>

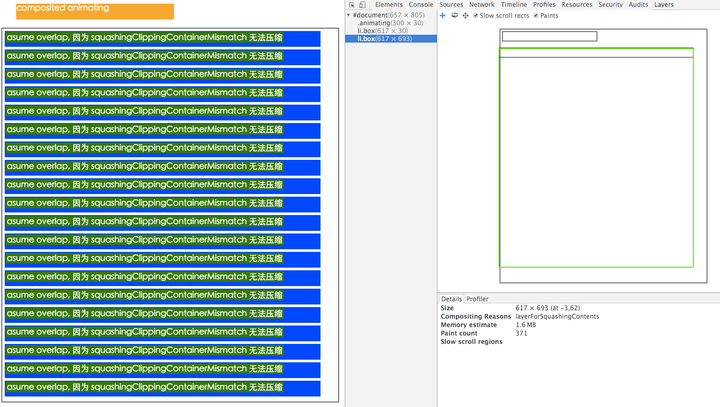
demo 中,.animating 的合成层在运行动画,会导致 .inner 元素因为上文介绍过的 assumedOverlap 的原因,而被提升为合成层,同时,.inner 的父元素 .box 设置了 overflow: hidden,导致 .inner 的合成层因为 squashingClippingContainerMismatch 的原因,无法压缩,就出现了层爆炸的问题。

img

这种情况平时在我们的业务中还是很常见的,比如 slider + list 的结构,一旦满足了无法进行层压缩的情况,就很容易出现层爆炸的问题。

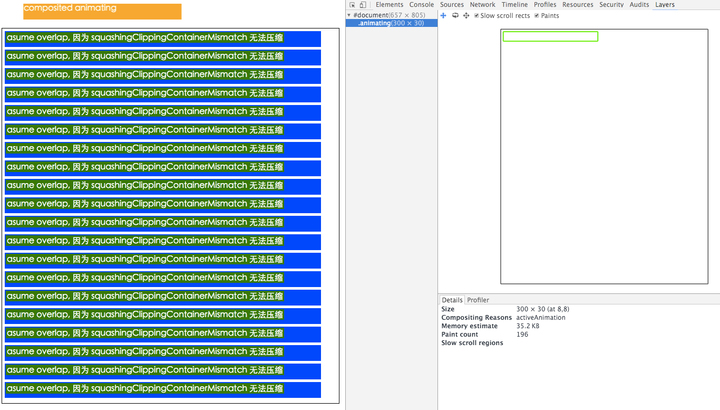
解决层爆炸的问题,最佳方案是打破 overlap 的条件,也就是说让其他元素不要和合成层元素重叠。对于上述的示例,我们可以将 .animation 的 z-index 提高。修改后 demo

1
2
3
4
5
6
7
.animating {

...
/* 让其他元素不和合成层重叠 */
position: relative;
z-index: 1;
}

此时,就只有 .animating 提升为合成层,如下:

img

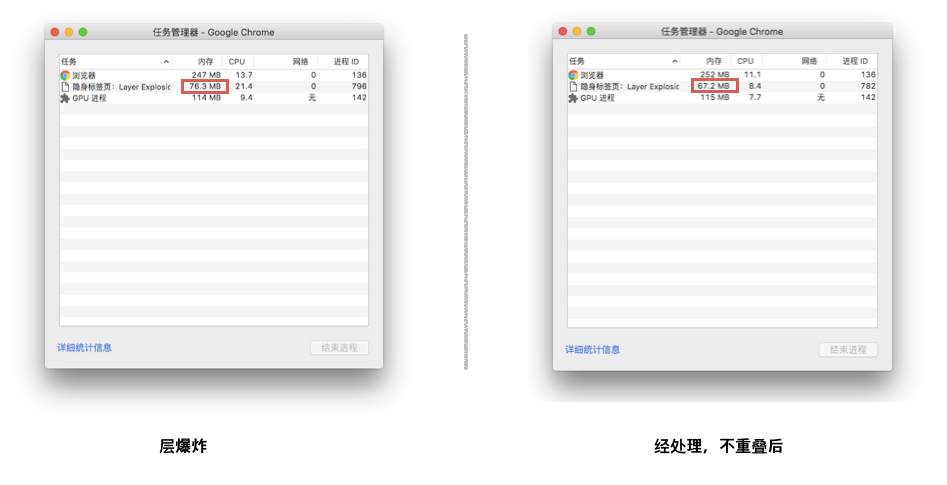
同时,内存占用比起之前也降低了很多。

img

如果受限于视觉需要等因素,其他元素必须要覆盖在合成层之上,那应该尽量避免无法层压缩情况的出现。针对上述示例中,无法层压缩的情况(squashingClippingContainerMismatch),我们可以将 .box 的 overflow: hidden 去掉,这样就可以利用浏览器的层压缩了。修改后 demo

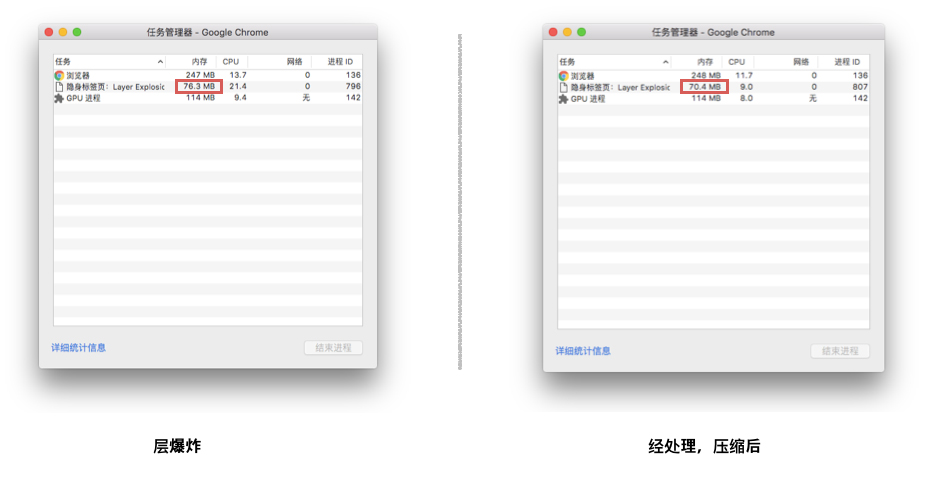
此时,由于第一个 .box 因为 squashingLayerIsAnimating 的原因无法压缩,其他的都被压缩到了一起。

img

同时,内存占用比起之前也降低了很多。

img

最后

之前无线开发时,大多数人都很喜欢使用 translateZ(0) 来进行所谓的硬件加速,以提升性能,但是性能优化并没有所谓的“银弹”,translateZ(0) 不是,本文列出的优化建议也不是。抛开了对页面的具体分析,任何的性能优化都是站不住脚的,盲目的使用一些优化措施,结果可能会适得其反。因此切实的去分析页面的实际性能表现,不断的改进测试,才是正确的优化途径。

声明

转载至淘宝,防止原链接失效

HTTP 通信过程包括从客户端发往服务器端的请求及从服务器端返回客户端的响应。

HTTP 报文

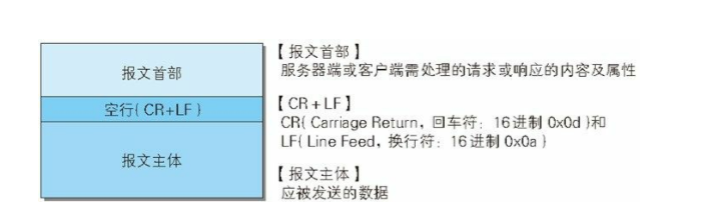
用于 HTTP 协议交互的信息被称为 HTTP 报文。请求端(客户端)的 HTTP 报文叫做请求报文,响应端(服务器端)的叫做响应报文。 HTTP 报文本身是由多行(用 CR+LF 作换行符)数据构成的字符串文本。
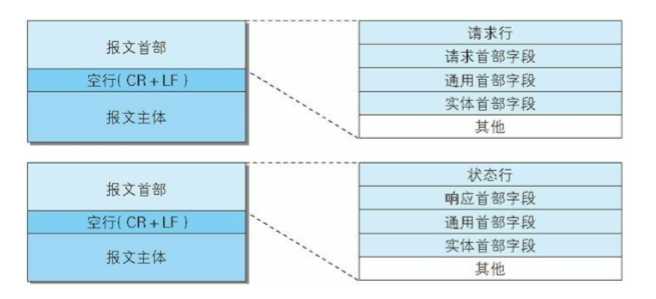
HTTP 报文大致可分为报文首部和报文主体两块。两者由最初出现的空行(CR+LF)来划分。通常,并不一定要有报文主体。
实例1

图:HTTP 报文的结构

请求报文及响应报文的结构

我们来看一下请求报文和响应报文的结构。
实例1
图:请求报文(上)和响应报文(下)的结构
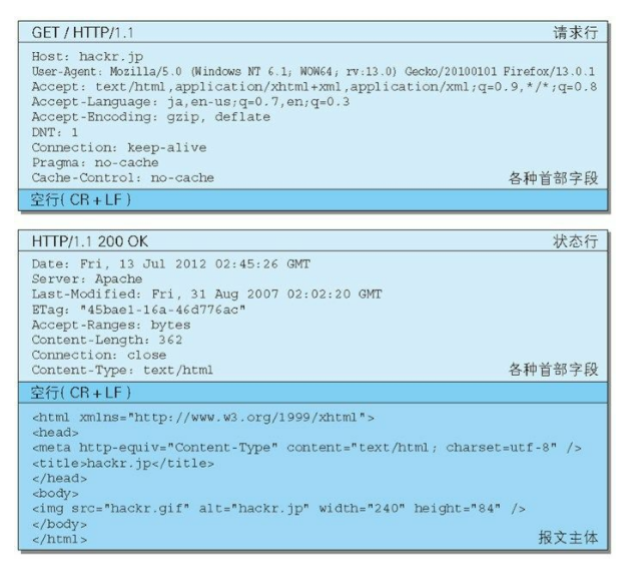
实例1
图:请求报文(上)和响应报文(下)的实例

请求报文和响应报文的首部内容由以下数据组成。现在出现的各种首部字段及状态码稍后会进行阐述。

  • 请求行
    包含用于请求的方法,请求 URI 和 HTTP 版本。
  • 状态行
    包含表明响应结果的状态码,原因短语和 HTTP 版本。
  • 首部字段
    包含表示请求和响应的各种条件和属性的各类首部。
    一般有 4 种首部,分别是:通用首部、请求首部、响应首部和实体首部。
  • 其他
    可能包含 HTTP 的 RFC 里未定义的首部(Cookie 等)。

编码提升传输速率

HTTP 在传输数据时可以按照数据原貌直接传输,但也可以在传输过 程中通过编码提升传输速率。通过在传输时编码,能有效地处理大量 的访问请求。但是,编码的操作需要计算机来完成,因此会消耗更多的 CPU 等资源。

报文主体和实体主体的差异

  • 报文(message)
    是 HTTP 通信中的基本单位,由 8 位组字节流(octet sequence, 其中 octet 为 8 个比特)组成,通过 HTTP 通信传输。
  • 实体(entity)
    作为请求或响应的有效载荷数据(补充项)被传输,其内容由实 体首部和实体主体组成。

通常,报文主体等于实体主体。只有当传输中进行编码操作时,实体 主体的内容发生变化,才导致它和报文主体产生差异。

压缩传输的内容编码

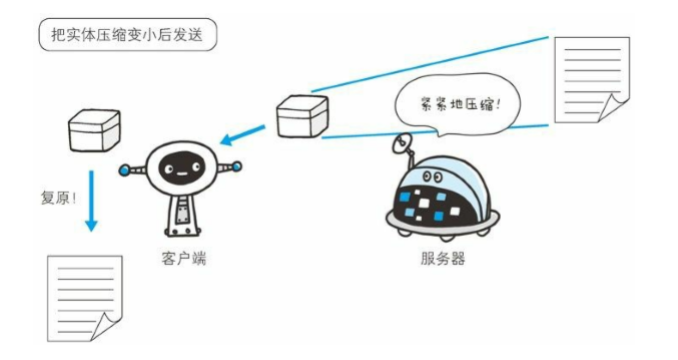
HTTP 协议中有一种被称为内容编码的功能也能进行类似的操作。内容编码指明应用在实体内容上的编码格式,并保持实体信息原样压缩。内容编码后的实体由客户端接收并负责解码。
实例1
图:内容编码
常用的内容编码有以下几种。

  • gzip(GNU zip)
  • compress(UNIX 系统的标准压缩)
  • deflate(zlib)
  • identity(不进行编码)

分割发送的分块传输编码

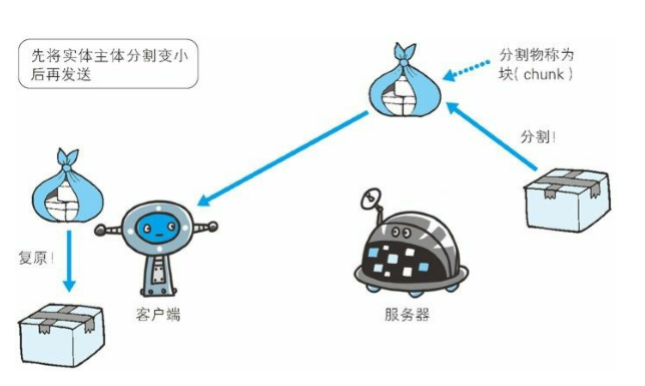
在传输大容量数据时,通过把数据分割成多块,这种把实体主体分块的功能称为分块传输编码(Chunked Transfer Coding)。
实例1
图:分块传输编码
分块传输编码会将实体主体分成多个部分(块)。每一块都会用十六 进制来标记块的大小,而实体主体的最后一块会使用0(CR+LF)来标记。
使用分块传输编码的实体主体会由接收的客户端负责解码,恢复到编码前的实体主体。

HTTP/1.1 中存在一种称为传输编码(Transfer Coding)的机制,它可 以在通信时按某种编码方式传输,但只定义作用于分块传输编码中。

发送多种数据的多部分对象集合

HTTP 协议中也采纳了多部分对象集合,发送的一份报文主 体内可含有多类型实体。通常是在图片或文本文件等上传时使用。

  • multipart/form-data 在 Web 表单文件上传时使用。
  • multipart/byteranges 状态码 206(Partial Content,部分内容)响应报文包含了多个范围的内容时使用。

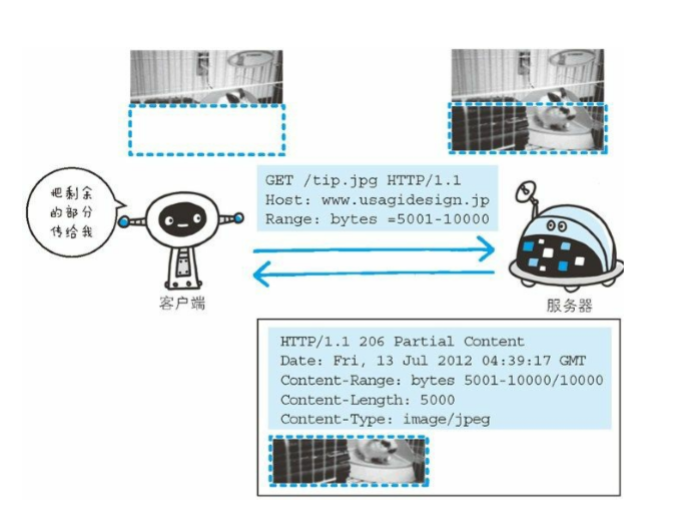
获取部分内容的范围请求

以前,用户不能使用现在这种高速的带宽访问互联网,当时,下载一个尺寸稍大的图片或文件就已经很吃力了。如果下载过程中遇到网络 中断的情况,那就必须重头开始。为了解决上述问题,需要一种可恢复的机制。所谓恢复是指能从之前下载中断处恢复下载。
要实现该功能需要指定下载的实体范围。像这样,指定范围发送的请 求叫做范围请求(Range Request)。

对一份 10000 字节大小的资源,如果使用范围请求,可以只请求 5001~10 000 字节内的资源。
实例1
执行范围请求时,会用到首部字段 Range 来指定资源的 byte 范围。

内容协商返回最合适的内容

当浏览器的默认语言为英语或中文,访问相同 URI 的 Web 页面时, 则会显示对应的英语版或中文版的 Web 页面。这样的机制称为内容 协商(Content Negotiation)。
包含在请求报文中的某些首部字段(如下)就是判断的基准。这些首 部字段的详细说明请参考下一章。

  • Accept Accept-Charset
  • Accept-Encoding
  • Accept-Language
  • Content-Language
    内容协商技术有以下 3 种类型。
  • 服务器驱动协商(Server-driven Negotiation)
    由服务器端进行内容协商。以请求的首部字段为参考,在服务器端自 动处理。但对用户来说,以浏览器发送的信息作为判定的依据,并不一定能筛选出最优内容。
  • 客户端驱动协商(Agent-driven Negotiation)
    由客户端进行内容协商的方式。用户从浏览器显示的可选项列表中手 动选择。还可以利用 JavaScript 脚本在 Web 页面上自动进行上述选 择。比如按 OS 的类型或浏览器类型,自行切换成 PC 版页面或手机 版页面。
  • 透明协商(Transparent Negotiation)
    是服务器驱动和客户端驱动的结合体,是由服务器端和客户端各自进 行内容协商的一种方法。

这个直接看浏览器原理 V8 第18节 有更详细的讲解
时间循环及消息队列

micro-task和macro-task就是两种不同的任务队列

  • macro-task:
    • script(script标签里面的整体代码)
    • setTimeout
    • setInterval
    • setImmediate
    • MessageChannel(vue nextTick 以前应该是备选方案)
    • I/O
    • UI rendering
    • requestAnimationFrame
  • micro-task:
    • process.nextTick
    • Promise
    • Object.observe(已废弃)
    • MutationObserver (接口提供了监视对DOM树所做更改的能力)

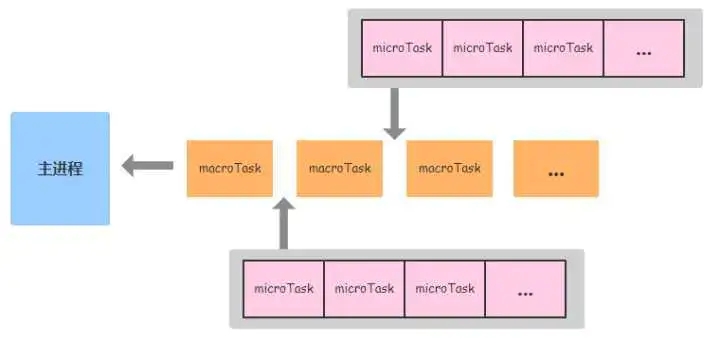
JS开发人员应该对这些方法都不会太陌生——都是些常见的异步操作。但这些方法在执行时有什么区别呢?通俗来说,macrotasks和microtasks最大的区别在它们会被放置在不同的任务调度队列中。我在网上找了一张图,如下所示:

  • 每个宏任务都会对应一个微任务列表
  • 微任务列表存储在环境变量中
  • 结论来自于v8原理 18节

示意图
每一次事件循环中,主进程都会先执行一个macroTask任务,这个任务就来自于所谓的MacroTask Queue队列;当该macroTask结束前,Event loop会立马调用microTask队列的任务,直到消费完所有的microtask,再继续下一个事件循环。

管中窥豹,microTask调用优先级较高于macroTask.
先看一个demo

1
2
3
4
5
6
7
8
9
10
11
12
13
console.log('main start');

setTimeout(() => {
console.log('setTimeout');
process.nextTick(() => console.log('process.nextTick 3'));
}, 0);

process.nextTick(() => {
console.log('process.nextTick 1');
process.nextTick(() => console.log('process.nextTick 2'));
});

console.log('main end');

看看它们的执行顺序是怎么样的:

1
2
3
4
5
6
1   main start
2 main end
3 process.nextTick 1
4 process.nextTick 2
5 setTimeout
6 process.nextTick 3

大致流程如下所示:

  1. 先运行主程序(事实上主程序本身就是一个macroTask),主程序把setTimeout和process.nextTick分别放入MacroTask Queue和MicroTask Queue

  2. 主程序结束,这时候我们看到了第一二条的打印结果main start、main end

  3. 如上面所提到的,每一个macroTask结束后会开始消费microTask。这时的MicroTask Queue里有一个process.nextTick,然后发现它本身也调用了一个process.nextTick,所以继续把这个内层的任务加入MicroTask Queue。

  4. 线程消费掉所有MicroTask Queue里的任务(这时只有两个任务),我们得到了第三四条结果process.nextTick 1和process.nextTick 2

  5. 当MicroTask Queue清空后,Event Loop进入下一个循环:执行MacroTask Queue的setTimeout任务,然后得到了第五条输出setTimeout,之后它还会把又一个process.nextTick放入MicroTask Queue

  6. 继续如4所示过程,Event Loop在Current MacroTask执行完成后消费MicroTask Queue,这时候我们有了最后一条输出process.nextTick 3

下面也是一道经常考的面试题,可以更好的理解async await

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
async function async1() {
console.log('async1 start'); // 2
await async2(); // 微任务 1
console.log('async1 end'); // 微任务 1 6
}
async function async2() {
console.log('async2'); // 3
}

console.log('script start'); // 1

setTimeout(function() {
console.log('setTimeout'); // 宏任务 1 8
}, 0)

async1();

new Promise(function(resolve) {
console.log('promise1'); // 4
resolve(); // 微任务 2
}).then(function() {
console.log('promise2'); // 微任务 2 7
});
console.log('script end'); // 5

转载自github 参考JS高程

本文讲解JavaScript各种继承方式和优缺点。

但是注意:

这篇文章更像是笔记,哎,再让我感叹一句:《JavaScript高级程序设计》写得真是太好了!

1.原型链继承

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
function Parent () {
this.name = 'kevin';
}

Parent.prototype.getName = function () {
console.log(this.name);
}

function Child () {

}

Child.prototype = new Parent();

var child1 = new Child();

console.log(child1.getName()) // kevin

问题:

1.引用类型的属性被所有实例共享,举个例子:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
function Parent () {
this.names = ['kevin', 'daisy'];
}

function Child () {

}

Child.prototype = new Parent();

var child1 = new Child();

child1.names.push('yayu');

console.log(child1.names); // ["kevin", "daisy", "yayu"]

var child2 = new Child();

console.log(child2.names); // ["kevin", "daisy", "yayu"]

2.在创建 Child 的实例时,不能向Parent传参

2.借用构造函数(经典继承)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
function Parent () {
this.names = ['kevin', 'daisy'];
}

function Child () {
Parent.call(this);
}

var child1 = new Child();

child1.names.push('yayu');

console.log(child1.names); // ["kevin", "daisy", "yayu"]

var child2 = new Child();

console.log(child2.names); // ["kevin", "daisy"]

优点:

1.避免了引用类型的属性被所有实例共享

2.可以在 Child 中向 Parent 传参

举个例子:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
function Parent (name) {
this.name = name;
}

function Child (name) {
Parent.call(this, name);
}

var child1 = new Child('kevin');

console.log(child1.name); // kevin

var child2 = new Child('daisy');

console.log(child2.name); // daisy

缺点:

方法都在构造函数中定义,每次创建实例都会创建一遍方法。

3.组合继承

原型链继承和经典继承双剑合璧。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
function Parent (name) {
this.name = name;
this.colors = ['red', 'blue', 'green'];
}

Parent.prototype.getName = function () {
console.log(this.name)
}

function Child (name, age) {

Parent.call(this, name);

this.age = age;

}

Child.prototype = new Parent();
Child.prototype.constructor = Child;

var child1 = new Child('kevin', '18');

child1.colors.push('black');

console.log(child1.name); // kevin
console.log(child1.age); // 18
console.log(child1.colors); // ["red", "blue", "green", "black"]

var child2 = new Child('daisy', '20');

console.log(child2.name); // daisy
console.log(child2.age); // 20
console.log(child2.colors); // ["red", "blue", "green"]

优点:融合原型链继承和构造函数的优点,是 JavaScript 中最常用的继承模式。

4.原型式继承

1
2
3
4
5
function createObj(o) {
function F(){}
F.prototype = o;
return new F();
}

就是 ES5 Object.create 的模拟实现,将传入的对象作为创建的对象的原型。

缺点:

包含引用类型的属性值始终都会共享相应的值,这点跟原型链继承一样。

1
2
3
4
5
6
7
8
9
10
11
12
13
var person = {
name: 'kevin',
friends: ['daisy', 'kelly']
}

var person1 = createObj(person);
var person2 = createObj(person);

person1.name = 'person1';
console.log(person2.name); // kevin

person1.firends.push('taylor');
console.log(person2.friends); // ["daisy", "kelly", "taylor"]

注意:修改person1.name的值,person2.name的值并未发生改变,并不是因为person1和person2有独立的 name 值,而是因为person1.name = 'person1',给person1添加了 name 值,并非修改了原型上的 name 值。

5. 寄生式继承

创建一个仅用于封装继承过程的函数,该函数在内部以某种形式来做增强对象,最后返回对象。

1
2
3
4
5
6
7
function createObj (o) {
var clone = Object.create(o);
clone.sayName = function () {
console.log('hi');
}
return clone;
}

缺点:跟借用构造函数模式一样,每次创建对象都会创建一遍方法。

6. 寄生组合式继承

为了方便大家阅读,在这里重复一下组合继承的代码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
function Parent (name) {
this.name = name;
this.colors = ['red', 'blue', 'green'];
}

Parent.prototype.getName = function () {
console.log(this.name)
}

function Child (name, age) {
Parent.call(this, name);
this.age = age;
}

Child.prototype = new Parent();

var child1 = new Child('kevin', '18');

console.log(child1)

组合继承最大的缺点是会调用两次父构造函数。

一次是设置子类型实例的原型的时候:

1
Child.prototype = new Parent();

一次在创建子类型实例的时候:

1
var child1 = new Child('kevin', '18');

回想下 new 的模拟实现,其实在这句中,我们会执行:

1
Parent.call(this, name);

在这里,我们又会调用了一次 Parent 构造函数。

所以,在这个例子中,如果我们打印 child1 对象,我们会发现 Child.prototype 和 child1 都有一个属性为colors,属性值为['red', 'blue', 'green']。

那么我们该如何精益求精,避免这一次重复调用呢?

如果我们不使用 Child.prototype = new Parent() ,而是间接的让 Child.prototype 访问到 Parent.prototype 呢?

看看如何实现:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
function inheritPrototype(subType, superType) {
let prototype = object(superType.prototype); // 创建对象
prototype.constructor = subType; // 增强对象
subType.prototype = prototype; // 赋值对象
}
function object(o) {
function F() {}
F.prototype = o;
return new F();
}
function SuperType(name) {
this.name = name;
this.colors = ["red", "blue", "green"];
}
SuperType.prototype.sayName = function () {
console.log(this.name);
};
function SubType(name, age) {
SuperType.call(this, name);
this.age = age;
}
inheritPrototype(SubType, SuperType);
SubType.prototype.sayAge = function () {
console.log(this.age);
};

引用《JavaScript高级程序设计》中对寄生组合式继承的夸赞就是:

这种方式的高效率体现它只调用了一次 Parent 构造函数,并且因此避免了在 Parent.prototype 上面创建不必要的、多余的属性。与此同时,原型链还能保持不变;因此,还能够正常使用 instanceof 和 isPrototypeOf。开发人员普遍认为寄生组合式继承是引用类型最理想的继承范式。

美团安全系列-XSS

美团安全系列-CSRF

1. XSS攻击

XSS(Cross-Site Scripting,跨站脚本攻击)是一种代码注入攻击。攻击者在目标网站上注入恶意代码,当被攻击者登陆网站时就会执行这些恶意代码,这些脚本可以读取 cookie,session tokens,或者其它敏感的网站信息,对用户进行钓鱼欺诈,甚至发起蠕虫攻击等。

XSS 的本质是:恶意代码未经过滤,与网站正常的代码混在一起;浏览器无法分辨哪些脚本是可信的,导致恶意脚本被执行。由于直接在用户的终端执行,恶意代码能够直接获取用户的信息,利用这些信息冒充用户向网站发起攻击者定义的请求。

XSS分类

根据攻击的来源,XSS攻击可以分为存储型(持久性)、反射型(非持久型)和DOM型三种。下面我们来详细了解一下这三种XSS攻击:

1.1 反射型XSS

当用户点击一个恶意链接,或者提交一个表单,或者进入一个恶意网站时,注入脚本进入被攻击者的网站。Web服务器将注入脚本,比如一个错误信息,搜索结果等,未进行过滤直接返回到用户的浏览器上。

反射型 XSS 的攻击步骤:

  1. 攻击者构造出特殊的 URL,其中包含恶意代码。
  2. 用户打开带有恶意代码的 URL 时,网站服务端将恶意代码从 URL 中取出,拼接在 HTML 中返回给浏览器。
  3. 用户浏览器接收到响应后解析执行,混在其中的恶意代码也被执行。
  4. 恶意代码窃取用户数据并发送到攻击者的网站,或者冒充用户的行为,调用目标网站接口执行攻击者指定的操作。

反射型 XSS 漏洞常见于通过 URL 传递参数的功能,如网站搜索、跳转等。由于需要用户主动打开恶意的 URL 才能生效,攻击者往往会结合多种手段诱导用户点击。

POST 的内容也可以触发反射型 XSS,只不过其触发条件比较苛刻(需要构造表单提交页面,并引导用户点击),所以非常少见。

注意Chrome 和 Safari 能够检测到 url 上的xss攻击,将网页拦截掉,但是其它浏览器不行,如Firefox

如果不希望被前端拿到cookie,后端可以设置 httpOnly (不过这不是 XSS攻击 的解决方案,只能降低受损范围)

如何防范反射型XSS攻击

对字符串进行编码。

对url的查询参数进行转义后再输出到页面。

1
2
3
4
app.get('/welcome', function(req, res) {
//对查询参数进行编码,避免反射型 XSS攻击
res.send(`${encodeURIComponent(req.query.type)}`);
});

1.2 DOM 型 XSS

DOM 型 XSS 攻击,实际上就是前端 JavaScript 代码不够严谨,把不可信的内容插入到了页面。在使用 .innerHTML、.outerHTML、.appendChild、document.write()等API时要特别小心,不要把不可信的数据作为 HTML 插到页面上,尽量使用 .innerText、.textContent、.setAttribute() 等。

DOM 型 XSS 的攻击步骤:

  1. 攻击者构造出特殊数据,其中包含恶意代码。
  2. 用户浏览器执行了恶意代码。
  3. 恶意代码窃取用户数据并发送到攻击者的网站,或者冒充用户的行为,调用目标网站接口执行攻击者指定的操作。

如何防范 DOM 型 XSS 攻击

防范 DOM 型 XSS 攻击的核心就是对输入内容进行转义(DOM 中的内联事件监听器和链接跳转都能把字符串作为代码运行,需要对其内容进行检查)。

1.对于url链接(例如图片的src属性),那么直接使用 encodeURIComponent 来转义。

2.非url,我们可以这样进行编码:

1
2
3
4
5
6
function encodeHtml(str) {
return str.replace(/"/g, '&quot;')
.replace(/'/g, '&apos;')
.replace(/</g, '&lt;')
.replace(/>/g, '&gt;');
}

DOM 型 XSS 攻击中,取出和执行恶意代码由浏览器端完成,属于前端 JavaScript 自身的安全漏洞。

1.3 存储型XSS

恶意脚本永久存储在目标服务器上。当浏览器请求数据时,脚本从服务器传回并执行,影响范围比反射型和DOM型XSS更大。存储型XSS攻击的原因仍然是没有做好数据过滤:前端提交数据至服务端时,没有做好过滤;服务端在接受到数据时,在存储之前,没有做过滤;前端从服务端请求到数据,没有过滤输出。

存储型 XSS 的攻击步骤:

  1. 攻击者将恶意代码提交到目标网站的数据库中。
  2. 用户打开目标网站时,网站服务端将恶意代码从数据库取出,拼接在 HTML 中返回给浏览器。
  3. 用户浏览器接收到响应后解析执行,混在其中的恶意代码也被执行。
  4. 恶意代码窃取用户数据并发送到攻击者的网站,或者冒充用户的行为,调用目标网站接口执行攻击者指定的操作。

这种攻击常见于带有用户保存数据的网站功能,如论坛发帖、商品评论、用户私信等。

如何防范存储型XSS攻击:

  1. 前端数据传递给服务器之前,先转义/过滤(防范不了抓包修改数据的情况)
  2. 服务器接收到数据,在存储到数据库之前,进行转义/过滤
  3. 前端接收到服务器传递过来的数据,在展示到页面前,先进行转义/过滤

1.4 防范XSS攻击

  • XSS(Cross-Site Scripting)攻击是一种常见的Web应用程序安全漏洞,攻击者利用漏洞在网站上注入恶意脚本或代码,以获取用户的敏感信息或控制用户的浏览器。为了防范XSS攻击,可以采取以下方法:

    1. 输入检查:在用户输入数据时,对数据进行检查和过滤,过滤掉特殊字符和脚本代码。比如可以使用HTML实体编码对特殊字符进行转义,比如<转义为<。
    2. 输出转义:在输出数据到页面上时,对数据进行转义。比如使用HTML实体编码将特殊字符转义成文本,这样就可以避免浏览器将其解析成HTML标签。比如将<转义为<。
    3. CSP(Content Security Policy):设置CSP响应头,限制页面中允许加载的资源类型,禁止内联脚本执行等,这样可以减少XSS攻击的影响。
    4. Cookie安全策略:使用HttpOnly和Secure属性,限制Cookie只能通过HTTP协议传输,防止Cookie被盗取。
    5. 防止DOM操作:对于不可信的数据,应该避免直接将其插入到DOM中,可以使用textContent或者innerText等属性插入数据,这样可以避免执行脚本。
    6. HTTPS传输:使用HTTPS协议传输数据,加密传输数据,防止数据被拦截和篡改。
    7. 前端框架的防护:一些前端框架(如Angular、React、Vue等)在渲染模板时会自动转义输出的内容,可以减少XSS攻击的风险。

    综上所述,防范XSS攻击需要综合采用多种方法,不同的方法可以在不同的层面上增强网站的安全性。

1.5 XSS 检测

读到这儿,相信大家已经知道了什么是XSS攻击,XSS攻击的类型,以及如何去防范XSS攻击。但是有一个非常重要的问题是:我们如何去检测XSS攻击,怎么知道自己的页面是否存在XSS漏洞?

很多大公司,都有专门的安全部门负责这个工作,但是如果没有安全部门,作为开发者本身,该如何去检测呢?

1.使用通用 XSS 攻击字串手动检测 XSS 漏洞

如:
jaVasCript:/*-/*/*`/*’/*”/**/(/* */oNcliCk=alert() )//%0D%0A%0d%0a//</stYle/</titLe/</teXtarEa/</scRipt/–!>\x3csVg/<sVg/oNloAd=alert()//>\x3e`

能够检测到存在于 HTML 属性、HTML 文字内容、HTML 注释、跳转链接、内联 JavaScript 字符串、内联 CSS 样式表等多种上下文中的 XSS 漏洞,也能检测 eval()、setTimeout()、setInterval()、Function()、innerHTML、document.write() 等 DOM 型 XSS 漏洞,并且能绕过一些 XSS 过滤器。

<img src=1 onerror=alert(1)>

2.使用第三方工具进行扫描


2. CSRF

CSRF(Cross-site request forgery)跨站请求伪造:攻击者诱导受害者进入第三方网站,在第三方网站中,向被攻击网站发送跨站请求。利用受害者在被攻击网站已经获取的注册凭证,绕过后台的用户验证,达到冒充用户对被攻击的网站执行某项操作的目的。

典型的CSRF攻击流程:

  1. 受害者登录A站点,并保留了登录凭证(Cookie)。
  2. 攻击者诱导受害者访问了站点B。
  3. 站点B向站点A发送了一个请求,浏览器会默认携带站点A的Cookie信息。
  4. 站点A接收到请求后,对请求进行验证,并确认是受害者的凭证,误以为是无辜的受害者发送的请求。
  5. 站点A以受害者的名义执行了站点B的请求。
  6. 攻击完成,攻击者在受害者不知情的情况下,冒充受害者完成了攻击。

CSRF的特点

1.攻击通常在第三方网站发起,如图上的站点B,站点A无法防止攻击发生。

2.攻击利用受害者在被攻击网站的登录凭证,冒充受害者提交操作;并不会去获取cookie信息(cookie有同源策略)

3.跨站请求可以用各种方式:图片URL、超链接、CORS、Form提交等等(来源不明的链接,不要点击)

CSRF 攻击防御

1. 添加验证码(体验不好)

验证码能够防御CSRF攻击,但是我们不可能每一次交互都需要验证码,否则用户的体验会非常差,但是我们可以在转账,交易等操作时,增加验证码,确保我们的账户安全。

2. 判断请求的来源:检测Referer(并不安全,Referer可以被更改)

1
`Referer` 可以作为一种辅助手段,来判断请求的来源是否是安全的,但是鉴于 `Referer` 本身是可以被修改的,因为不能仅依赖于  `Referer`

3. 使用Token(主流)

1
2
3
4
5
CSRF攻击之所以能够成功,是因为服务器误把攻击者发送的请求当成了用户自己的请求。那么我们可以要求所有的用户请求都携带一个CSRF攻击者无法获取到的Token。服务器通过校验请求是否携带正确的Token,来把正常的请求和攻击的请求区分开。跟验证码类似,只是用户无感知。

- 服务端给用户生成一个token,加密后传递给用户
- 用户在提交请求时,需要携带这个token
- 服务端验证token是否正确

4. Samesite Cookie属性

阮一峰samesite

为了从源头上解决这个问题,Google起草了一份草案来改进HTTP协议,为Set-Cookie响应头新增Samesite属性,它用来标明这个 Cookie是个“同站 Cookie”,同站Cookie只能作为第一方Cookie,不能作为第三方Cookie,Samesite 有两个属性值,分别是 Strict 和 Lax。

部署简单,并能有效防御CSRF攻击,但是存在兼容性问题。

Samesite=Strict

Samesite=Strict 被称为是严格模式,表明这个 Cookie 在任何情况都不可能作为第三方的 Cookie,有能力阻止所有CSRF攻击。此时,我们在B站点下发起对A站点的任何请求,A站点的 Cookie 都不会包含在cookie请求头中。

Samesite=Lax

Samesite=Lax 被称为是宽松模式,与 Strict 相比,放宽了限制,允许发送安全 HTTP 方法带上 Cookie,如 Get / OPTIONS 、HEAD 请求.

但是不安全 HTTP 方法,如: POST, PUT, DELETE 请求时,不能作为第三方链接的 Cookie

为了更好的防御CSRF攻击,我们可以组合使用以上防御手段。

3. 点击劫持

点击劫持是指在一个Web页面中隐藏了一个透明的iframe,用外层假页面诱导用户点击,实际上是在隐藏的frame上触发了点击事件进行一些用户不知情的操作。

典型点击劫持攻击流程

  1. 攻击者构建了一个非常有吸引力的网页
  2. 将被攻击的页面放置在当前页面的 iframe 中
  3. 使用样式将 iframe 叠加到非常有吸引力内容的上方
  4. 将iframe设置为100%透明
  5. 你被诱导点击了网页内容,你以为你点击的是***,而实际上,你成功被攻击了。

点击劫持防御

1. frame busting

Frame busting

1
2
3
if ( top.location != window.location ){
top.location = window.location
}

需要注意的是: HTML5中iframe的 sandbox 属性、IE中iframe的security 属性等,都可以限制iframe页面中的JavaScript脚本执行,从而可以使得 frame busting 失效。

2. X-Frame-Options

X-FRAME-OPTIONS是微软提出的一个http头,专门用来防御利用iframe嵌套的点击劫持攻击。并且在IE8、Firefox3.6、Chrome4以上的版本均能很好的支持。

可以设置为以下值:

  • DENY: 拒绝任何域加载
  • SAMEORIGIN: 允许同源域下加载
  • ALLOW-FROM: 可以定义允许frame加载的页面地址
0%